
Element finden, Interaktivität abwarten, Aktion auslösen und Ergebnis prüfen: Ein Automatisierungsschritt besteht aus diesen vier Phasen. Wer Selektoren, dynamisches Laden, iframes und Shadow DOM versteht, baut langlebigere Skripte.
Web-Automatisierung wird oft als Programm verstanden, das für dich auf Schaltflächen klickt. Beim tatsächlichen Implementieren zeigt sich jedoch: Eine Aktion besteht aus vier Schritten, und wenn nur einer davon nicht stimmt, wirkt es schnell so, als wäre gar nichts passiert.
Zuerst zwei Begriffe, die leicht verwechselt werden. Web-Automatisierung ist der weiter gefasste Begriff: Alles, was ein Programm anstelle eines Menschen auf einer Webseite erledigt, zählt dazu, auch das direkte Abrufen von Daten per Request. Browser-Automatisierung ist ein konkreterer Teil davon: Ein Programm steuert einen echten Browser, öffnet Seiten, führt JavaScript aus und simuliert Klicks und Eingaben. Bei vielen dynamischen Inhalten oder komplexen Interaktionen ist meist dieser zweite Weg nötig.
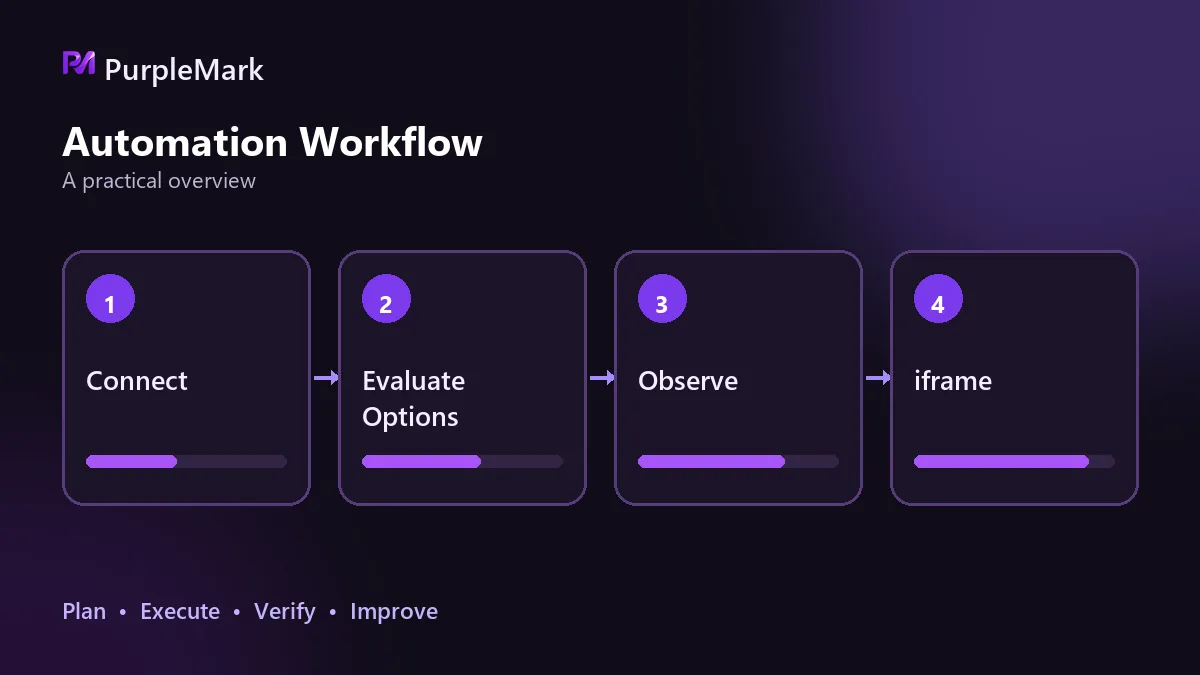
Die vier Schritte einer Aktion
- Element finden: Das Ziel mit id, name, class, CSS-Selektor oder XPath bestimmen. Semantische Attribute bevorzugen und erst bei Bedarf auf Struktur oder Index zurückgreifen.
- Interaktivität abwarten: Nur weil ein Element im DOM vorhanden ist, lässt es sich noch nicht anklicken. Warte, bis es sichtbar oder klickbar ist oder bis eine bestimmte Anfrage zurückkommt. Gewartet wird auf eine Bedingung, nicht auf eine Anzahl Sekunden.
- Aktion auslösen: Klicken, eingeben oder scrollen. Benutzerdefinierte Komponenten erfordern oft dieselbe Reihenfolge wie bei einem Menschen: zuerst öffnen, dann auf das Rendern der Liste warten und anschließend nach Text auswählen.
- Ergebnis prüfen: Nach der Aktion kontrollieren, ob das Ergebnis stimmt. Prüfe, ob sich ein Link oder der Seitentext geändert hat oder was die API zurückgegeben hat. Ohne diesen Schritt können Fehler als Erfolg gelten, und spätere Wiederholungen oder Warnungen haben keine verlässliche Grundlage.
Von den vier Schritten beanspruchen der zweite und der vierte meist die meiste Debugging-Zeit. Nicht weil sie besonders schwierig sind, sondern weil sie oft keinen Fehler auslösen und stattdessen still ein falsches Ergebnis erzeugen.
Die Stabilität des Selektors bestimmt die Lebensdauer des Skripts
Ändert sich die Seite, versagen fest codierte Locator schnell. Lokalisierung anhand von Text, Position oder Index ist am anfälligsten: Schon eine zusätzliche Schaltfläche oder ein geänderter Hinweis kann alles verschieben.
Wenn möglich, id-, name- oder data-Attribute verwenden. Falls strukturelle Locator nötig sind, sollten sie zentral an einer Stelle liegen, damit Änderungen nicht über Dutzende Codezeilen verteilt werden müssen. Auch ein fertiges Skript bleibt wartungsbedürftig: Websites ändern sich regelmäßig, und ein großer Teil des Wartungsaufwands entsteht genau hier.
Dynamisches Laden: Was du abwartest, ist wichtiger als wie lange
Nur wenige Seiten sind direkt nach dem ersten Laden vollständig bereit. Daten werden über asynchrone Anfragen gerendert, daher erscheinen Elemente oft später als erwartet.
Feste Wartezeiten sind verbreitet und zugleich besonders fehleranfällig: Drei Sekunden Schlaf können auf einem langsamen Rechner zu kurz sein und auf einem schnellen nur Zeit verschwenden. Besser ist es, auf eine konkrete Bedingung zu warten und erst zu handeln, wenn das Element wirklich klickbar ist.
Wenn ein Element nicht gefunden wird, zuerst iframe und Shadow DOM prüfen
Ist ein Element sichtbar, aber das Skript findet es nicht, liegt es häufig nicht am Selektor, sondern am falschen Gültigkeitsbereich.
Ein iframe ist ein eigenständiges Dokument. Vor der Elementsuche muss in den passenden Frame gewechselt und danach wieder herausgewechselt werden, sonst laufen spätere Suchen im falschen Kontext. Knoten in einem Shadow DOM werden von CSS-Selektoren außerhalb davon nicht direkt getroffen; zuerst braucht man den shadow root und sucht anschließend darin. Beide Fälle werden oft fälschlich für ein Redesign der Seite gehalten und kosten unnötig Debugging-Zeit.
Zwei weitere Punkte werden leicht übersehen
Der erste ist die Sitzung. Bei Aufgaben mit Anmeldung muss geklärt sein, wie der Login-Status gespeichert und wiederverwendet wird. Sonst ist bei jedem Lauf eine neue Anmeldung nötig, die zudem an einer Verifizierung hängen bleiben kann.
Der zweite ist die Umgebung. Wenn alle Aufgaben dieselbe Browser-Umgebung teilen, können sich Sitzungen und Caches gegenseitig beeinflussen. Aufgaben, die getrennt problemlos laufen, stören sich dann gemeinsam. Sobald aus einer Aufgabe mehrere werden, spart eine eigene Schicht zur Umgebungsisolation viel Aufwand. Tools wie PurpleMark stellen dafür pro Umgebung einen eigenen Fingerprint und einen eigenen Proxy bereit, während das Automatisierungsframework nur die Aktionen ausführt.
Eine Grenze sollte vor dem Start geklärt sein
Automatisierung kann wiederkehrende Arbeit ersetzen, aber keine Schritte, die eine echte Person erfordern. Enthält der Zielprozess etwa eine Echtzeit-Gesichtsprüfung oder manuelle Prüfung, lässt sich dieser Ablauf nicht zu 100 % automatisieren.
Prüfe den Prozess deshalb zunächst auf die einfachste Weise: Führe ihn einmal vollständig manuell durch, notiere jeden Schritt und stelle fest, ob es unüberwindbare Stationen gibt. Erst danach sollte entschieden werden, wie viel Entwicklungsaufwand sinnvoll ist. Technische Machbarkeit und zulässige Nutzung sind außerdem zwei verschiedene Fragen; die Nutzungsbedingungen der Zielplattform sollten daher vorher geprüft werden.


