
Localizar el elemento, esperar a que sea interactivo, ejecutar la acción y verificar el resultado: una acción automatizada se compone de estos cuatro pasos. Entender selectores, carga dinámica, iframes y shadow DOM ayuda a crear scripts más duraderos.
La automatización web suele entenderse como hacer que un programa pulse botones por ti. Pero al implementarla de verdad se descubre que cada acción tiene cuatro pasos y que, si cualquiera falla, puede parecer que no ocurrió nada.
Primero conviene distinguir dos conceptos que se confunden con facilidad. La automatización web es el término más amplio: incluye usar un programa para hacer lo que normalmente haría una persona en una página web, incluso obtener datos directamente mediante solicitudes. La automatización del navegador es una rama más concreta: el programa controla un navegador real para abrir páginas, ejecutar JavaScript y simular clics y escritura. Cuando hay mucho contenido dinámico o interacciones complejas, normalmente hay que seguir esta segunda vía.
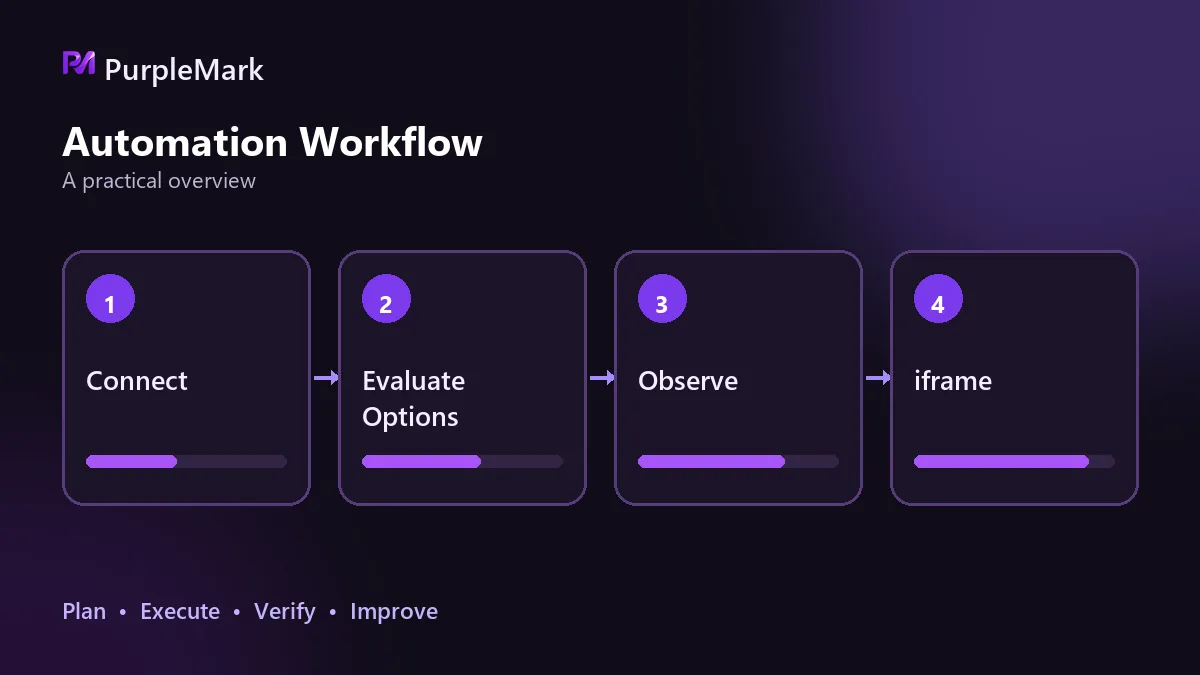
Los cuatro pasos de una acción
- Localizar el elemento: Identifica el objetivo con id, name, class, selectores CSS o XPath. Prioriza atributos semánticos y recurre a la estructura o al índice solo cuando no haya otra opción.
- Esperar a que sea interactivo: Que un elemento esté en el DOM no significa que ya se pueda pulsar. Espera a que sea visible, clicable o a que responda una solicitud concreta. Se espera una condición, no un número de segundos.
- Ejecutar la acción: Hacer clic, escribir o desplazarse. Los componentes personalizados suelen exigir reproducir el orden de una persona: abrir primero, esperar a que se renderice la lista y luego seleccionar por texto.
- Verificar el resultado: Después de actuar, comprueba que el resultado sea correcto. Revisa si cambió el enlace, si cambió el texto de la página o qué devolvió la API. Sin esta fase, un fallo puede darse por éxito y no habrá una base fiable para reintentos o alertas.
De los cuatro pasos, el segundo y el cuarto suelen requerir más tiempo de depuración. No porque sean difíciles, sino porque a menudo no generan errores y producen silenciosamente un resultado incorrecto.
La estabilidad del selector determina cuánto dura el script
Cuando cambia la página, las localizaciones codificadas de forma rígida dejan de funcionar. Localizar por texto, posición o índice es lo menos resistente a cambios: añadir un botón o modificar un mensaje puede desajustarlo todo.
Siempre que sea posible, usa atributos id, name o data. Si necesitas localizadores estructurales, centralízalos en un solo lugar para que un cambio no obligue a editar decenas de líneas. Tampoco esperes escribir el script y olvidarte de él: los sitios web cambian con frecuencia y gran parte del coste de mantenimiento se concentra aquí.
Carga dinámica: importa más qué esperas que cuánto esperas
Hoy pocas páginas tienen todo listo al terminar la carga inicial. Los datos se renderizan mediante solicitudes asíncronas y los elementos aparecen más tarde de lo esperado.
Las esperas fijas son habituales y también una fuente frecuente de fallos: dormir 3 segundos puede ser insuficiente en un equipo lento y una pérdida de tiempo en uno rápido. Lo correcto es esperar a que se cumpla una condición y actuar solo cuando el elemento sea realmente clicable.
Si no encuentras un elemento, revisa primero iframe y shadow DOM
Cuando el elemento está claramente en la página pero el script no lo encuentra, muchas veces el problema no es el selector, sino el ámbito.
Un iframe es un documento independiente. Hay que cambiar primero al frame correspondiente para buscar el elemento y volver después al contexto exterior; de lo contrario, las búsquedas posteriores se harán en el contexto equivocado. Los nodos dentro de un shadow DOM no se alcanzan directamente con selectores CSS desde fuera; primero hay que obtener el shadow root y buscar dentro de él. Ambos casos suelen confundirse con un rediseño de la página y hacen perder mucho tiempo.
Otras dos cosas fáciles de pasar por alto
La primera es la sesión. En tareas que requieren inicio de sesión, hay que pensar cómo guardar y reutilizar el estado autenticado. Si no, cada ejecución obliga a iniciar sesión de nuevo y puede quedarse bloqueada en una verificación.
La segunda es el entorno. Si todas las tareas comparten un mismo entorno de navegador, las sesiones y las cachés pueden contaminarse entre sí. Tareas que funcionan bien por separado pueden empezar a interferirse al ejecutarse juntas. Cuando se pasa de una tarea a varias, separar el aislamiento del entorno en una capa propia ahorra muchos problemas. Herramientas como PurpleMark aportan un fingerprint independiente y un proxy independiente para cada entorno, mientras el framework de automatización se ocupa de ejecutar las acciones.
Conviene confirmar un límite antes de empezar
La automatización puede sustituir operaciones repetitivas, pero no los pasos que requieren la participación de una persona. Si el flujo objetivo incluye verificación facial en tiempo real o revisión manual, no podrá automatizarse al 100 %.
Por eso, primero valida el flujo de la forma más simple: recórrelo manualmente de principio a fin, anota cada paso y comprueba si hay alguno que no pueda superarse. Solo entonces decide cuánto desarrollo merece la pena invertir. La viabilidad técnica y lo permitido por las reglas también son asuntos distintos, así que revisa con antelación los términos de servicio de la plataforma objetivo.


