
Przeglądarki uruchamiane przez Selenium mogą różnić się portami debugowania, właściwościami odczytywanymi przez stronę i sposobem startu. Część ustawień można rozsądnie dostosować, natomiast próby ukrywania samej automatyzacji są kruche, zbędne i często mało skuteczne.
Podczas automatyzacji z użyciem Selenium może się zdarzyć, że logika skryptu jest poprawna, a mimo to nie uzyskuje się oczekiwanego wyniku. Pierwszym odruchem bywa zmiana jednego lub dwóch parametrów, lecz środowisko zwykle zdradza nie pojedynczy przełącznik, ale zestaw różnic na kilku poziomach. Rozdzielenie tych warstw pomaga ocenić, co rzeczywiście warto konfigurować, a co raczej nie przyniesie efektu.
Porty debugowania i artefakty środowiska uruchomieniowego
Sposób, w jaki Selenium steruje przeglądarką, pozostawia dwa rodzaje śladów. Po pierwsze, podczas startu przeglądarka może otworzyć port debugowania, przez który zewnętrzne oprogramowanie może przejąć kontrolę nad stroną. Po drugie, w środowisku uruchomieniowym mogą pojawić się dodatkowe elementy, takie jak globalne zmienne z prefiksem cdc_ wstrzykiwane przez sterownik, dodatkowe obiekty sterownika w window oraz zmodyfikowane fragmenty niektórych prototypów obiektów.
Elementy te nie pochodzą ze strony internetowej, lecz z samego sterownika. Przy standardowym sposobie uruchomienia są obecne niezależnie od tego, jak dobrze napisano skrypt.
Właściwości możliwe do odczytania przez stronę
Inny rodzaj śladu nie znajduje się w sterowniku, lecz w środowisku JavaScript widocznym dla strony. Najczęściej przywoływanym przykładem jest navigator.webdriver.
Ta właściwość może mieć trzy wartości. true oznacza, że przeglądarka jest sterowana przez narzędzie automatyzacji, false oznacza brak takiego sterowania, a undefined oznacza brak dostępu do tej informacji, zwykle dlatego, że przeglądarka nie udostępnia właściwości lub została ona w jakiś sposób zmieniona. Podczas zwykłego korzystania przez człowieka wartość to false albo undefined, natomiast Selenium domyślnie uruchamia przeglądarkę z wartością true.
Wokół tego istnieje szerszy zestaw parametrów: User-Agent, system operacyjny i wersja przeglądarki, rozdzielczość ekranu, strefa czasowa, język, Canvas, WebGL, AudioContext, lista czcionek, model GPU i liczba rdzeni CPU. Razem tworzą to, co zwykle nazywa się odciskiem przeglądarki. U prawdziwych użytkowników odciski są naturalnie zróżnicowane, ponieważ różnią się systemy, oprogramowanie i nawyki. Przeglądarki uruchamiane z domyślną konfiguracją automatyzacji mogą natomiast tworzyć bardzo podobne kombinacje, przez co łatwiej przypisać je do znanych wzorców.
Różnice wynikające ze sposobu startu i czasu renderowania
Trzecia kategoria nie dotyczy pojedynczej właściwości, lecz całościowych różnic wynikających ze sposobu uruchomienia i renderowania przeglądarki.
Start z flagami automatyzacji, praca w trybie headless, niespójne parametry okna i ekranu, niepasujące połączenie renderowania czcionek ze sterownikiem graficznym albo zbyt równomierny czas od załadowania strony do gotowości do interakcji nie stanowią dowodu, gdy występują osobno. W połączeniu mogą jednak tworzyć środowisko, które mało przypomina urządzenie używane przez realną osobę.
Headless jest typowym przykładem. W nowszych wersjach Chrome tryb headless znacznie bardziej przypomina zwykłą przeglądarkę niż kilka lat temu, ale nadal może ujawniać cechy automatyzacji łatwiej niż tryb standardowy, szczególnie w serwisach ze ścisłymi mechanizmami kontroli ryzyka.
Co można rozsądnie konfigurować
Strefa czasowa, język, rozdzielczość ekranu i lista czcionek nie są unikalne dla automatyzacji. Rzeczywiste urządzenia naturalnie różnią się pod tym względem. Najważniejsza jest spójność wewnętrzna: strefa czasowa powinna pasować do regionu wyjścia sieciowego, język do typowego regionu użytkowania, a rozdzielczość nie powinna kłócić się z profilem sprzętu.
Innymi słowy, celem nie jest uczynienie środowiska wyjątkowym, lecz logicznie spójnym. Jeśli urządzenie wygląda na łączące się z Niemiec, ale przeglądarka zgłasza strefę czasową zachodniego wybrzeża USA, system ma wyłącznie język angielski, a rozdzielczość wygląda jak typowa dla wirtualnego ekranu, taka kombinacja sama w sobie jest już wystarczająco nietypowa.
Dlatego ustawienia środowiska najlepiej przechowywać w sposób trwały. Zmiana strefy czasowej dziś i zapomnienie o języku jutro może stworzyć większą niespójność niż pozostawienie obu parametrów bez zmian.
Co próbuje ukryć samą automatyzację i dlaczego nie warto tego robić
Inna klasa technik celuje bezpośrednio w ślady: usuwanie navigator.webdriver, kasowanie zmiennych wstrzykniętych przez sterownik, ukrywanie obiektów sterownika albo inne próby uniemożliwienia odczytu stanu automatyzacji.
Problem polega na tym, że takie metody zmieniają powierzchnię, a nie zachowanie leżące u podstaw. Systemy wykrywania od dawna nie sprawdzają tylko jednej właściwości; odczyt atrybutów jest jedynie najbardziej powierzchowną warstwą. Aktualizacja sterownika, zmiana kolejności wykonywania skryptu wykrywającego albo kontrola omijająca JavaScript i analizująca bezpośrednio niskopoziomowe wyniki renderowania oraz kombinacje cech urządzenia może sprawić, że wcześniejsze poprawki przestaną działać. Koszt utrzymania pozostaje znaczny, a korzyść nadal maleje.
W praktyce takie działania często trafiają dokładnie w obszar, który regulaminy platform określają jako omijanie technicznych środków ochrony. Starannie napisany kod nie zmienia charakteru działania tylko dlatego, że zmodyfikowano kilka właściwości.
Warstwy sieciowej nie da się naprawić w skrypcie
Nawet jeśli środowisko przeglądarki wydaje się spójne, warstwa sieciowa nadal może zidentyfikować sesję. Może brać pod uwagę, czy IP należy do centrum danych, serwera chmurowego czy sieci proxy, historyczną reputację zakresu IP i jego ASN, geolokalizację, gęstość żądań z tego samego IP oraz to, czy adres odwiedza wiele kont lub stron w krótkim czasie. Cookies, Sessions i stan logowania przesyłane w żądaniach również mogą być ze sobą korelowane.
Tego nie da się rozwiązać wewnątrz skryptu; wymaga to działania na poziomie środowiska: osobnego wyjścia dla każdego zadania, zgodności regionu wyjścia z regionem środowiska oraz kontrolowanego tempa żądań. Przy izolacji wielu zadań możliwości takie jak PurpleMark zwykle działają właśnie na tym poziomie, zapewniając każdemu zadaniu niezależne środowisko przeglądarki i wyjście sieciowe przy zachowaniu spójności parametrów geograficznych.
Praktyczna kolejność diagnostyki po zablokowaniu dostępu
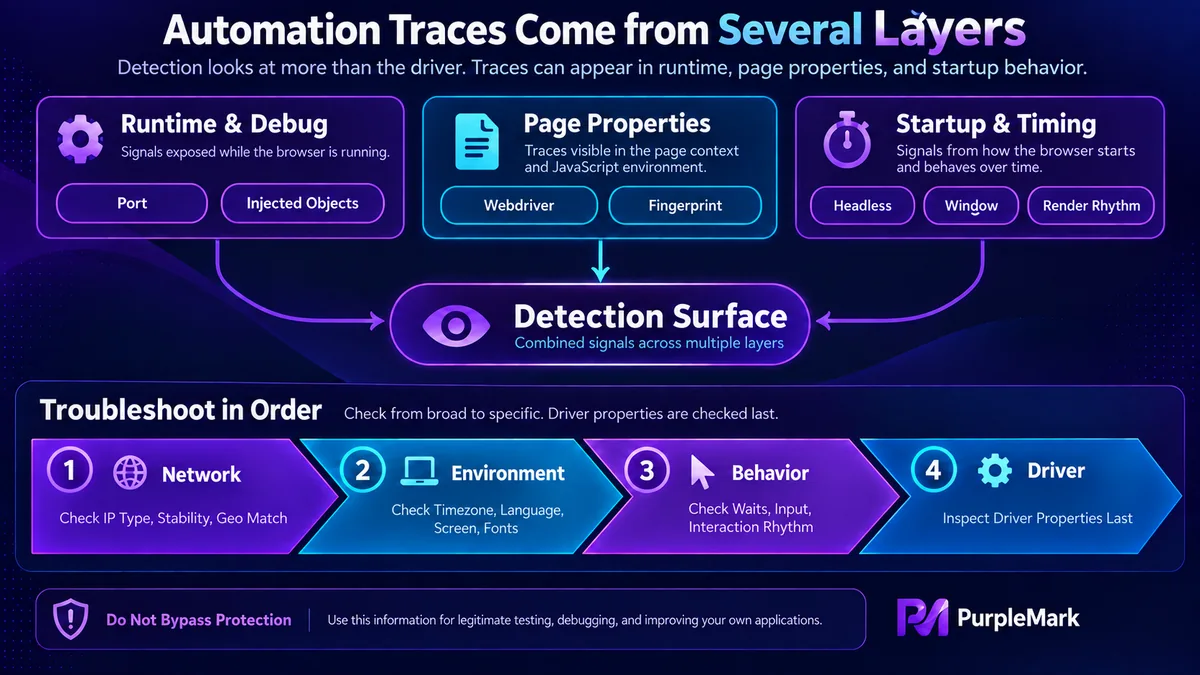
Rozsądna kolejność jest następująca: najpierw sprawdzić warstwę sieciową pod kątem typu IP, stabilności i zgodności geograficznej; następnie zweryfikować spójność środowiska między strefą czasową, językiem, rozdzielczością i czcionkami; potem przyjrzeć się rytmowi zachowania, na przykład stałym czasom oczekiwania lub natychmiastowemu wprowadzaniu danych; a dopiero na końcu sprawdzić właściwości automatyzacji na poziomie sterownika.
Powód jest prosty: artefakty sterownika nie są już głównym celem mechanizmów wykrywania. Umieszczenie ich na początku diagnostyki zwykle oznacza stratę czasu.
Granice
Środki techniczne mogą zmniejszyć prawdopodobieństwo identyfikacji, ale nie należy przekraczać pewnych granic: trzeba przestrzegać zasad robots i warunków korzystania z docelowej witryny, nie zbierać danych osobowych, nie omijać technicznych środków ochrony, kontrolować częstotliwość żądań i nie zakłócać normalnego działania usługi.


