
Los navegadores iniciados por Selenium pueden diferir en los puertos de depuración, las propiedades que puede leer una página y la forma de arranque. Algunas diferencias admiten una configuración razonable; ocultar la automatización en sí suele ser innecesario, frágil y poco eficaz.
Al automatizar con Selenium, puede ocurrir que la lógica del script sea correcta y aun así no se obtenga el resultado esperado. La primera reacción suele ser cambiar uno o dos parámetros, pero lo que realmente delata al entorno casi nunca es un único interruptor, sino varias diferencias en capas distintas. Separar esas capas permite ver qué merece la pena configurar y qué probablemente no dará resultado.
Puertos de depuración y artefactos en tiempo de ejecución
La forma en que Selenium controla el navegador deja dos tipos de rastros. El primero es el puerto de depuración que puede abrirse al iniciar el navegador y que permite a software externo tomar el control de la página. El segundo son elementos adicionales en el entorno de ejecución, como variables globales con el prefijo cdc_ inyectadas por el controlador, objetos adicionales del controlador en window y partes modificadas de algunos prototipos de objetos.
Estos elementos no proceden de la página web, sino del propio controlador. Si el navegador se inicia de la forma estándar, estarán ahí independientemente de lo bien escrito que esté el script.
Propiedades que puede leer la página
Otra clase de rastro no está en el controlador, sino en el entorno JavaScript que la página puede leer. El ejemplo más citado es navigator.webdriver.
Esta propiedad puede tener tres valores. true indica que el navegador está siendo controlado por una herramienta de automatización, false indica que no lo está y undefined significa que esa información no está disponible, normalmente porque el navegador no expone la propiedad o porque ha sido modificada. En una visita humana normal suele ser false o undefined, mientras que Selenium la establece en true al iniciarse de forma predeterminada.
A su alrededor hay muchos otros parámetros: User-Agent, sistema operativo y versión del navegador, resolución de pantalla, zona horaria, idioma, Canvas, WebGL, AudioContext, lista de fuentes, modelo de GPU y número de núcleos de CPU. En conjunto forman lo que se suele llamar huella digital del navegador. Los usuarios reales tienen huellas naturalmente diversas por las diferencias de sistema, software y hábitos. En cambio, los navegadores ejecutados con configuraciones de automatización predeterminadas tienden a producir combinaciones muy parecidas, lo que facilita agruparlos en patrones conocidos.
Diferencias debidas al modo de arranque y al tiempo de renderizado
La tercera categoría no depende de una sola propiedad, sino de las diferencias globales que introduce la forma de iniciar y renderizar el navegador.
Iniciar con indicadores de automatización, ejecutar en modo headless, usar tamaños de ventana que no coinciden con los parámetros de pantalla, combinar de forma poco coherente el renderizado de fuentes con los controladores gráficos o mostrar tiempos demasiado uniformes desde la carga hasta la interacción no constituye una prueba por separado. Sin embargo, la suma de estos factores puede formar un entorno poco parecido al de un usuario real.
El modo Headless es un ejemplo típico. Las versiones recientes de Chrome en modo headless se parecen mucho más a un navegador normal que hace unos años, pero todavía pueden revelar características de automatización con mayor facilidad que el modo convencional, especialmente en sitios con controles de riesgo estrictos.
Qué se puede configurar de forma razonable
La zona horaria, el idioma, la resolución de pantalla y la lista de fuentes no son elementos exclusivos de la automatización. Los dispositivos reales también varían. Lo importante es que estos parámetros sean coherentes entre sí: la zona horaria debe corresponder a la región de la salida de red, el idioma a la región habitual y la resolución no debe contradecir el perfil de hardware.
Dicho de otra forma, el objetivo no es que el entorno parezca especial, sino que tenga sentido internamente. Si un dispositivo parece acceder desde Alemania, pero el navegador informa de una zona horaria de la costa oeste de EE. UU., el sistema solo usa inglés y la resolución de pantalla es típica de una pantalla virtual, esa combinación ya resulta suficientemente llamativa.
Por eso conviene guardar la configuración del entorno de forma persistente. Cambiar hoy la zona horaria y olvidar mañana el idioma puede generar más incoherencias que no cambiar nada.
Qué intenta ocultar la automatización y por qué no merece la pena
Hay otra clase de técnicas que apunta directamente a los rastros: eliminar navigator.webdriver, borrar variables inyectadas por el controlador, ocultar objetos del controlador o impedir de otras maneras que el detector lea el estado de automatización.
El problema es que estas técnicas modifican la superficie, no el comportamiento subyacente. Los sistemas de detección hace tiempo que dejaron de mirar una sola propiedad; leer atributos es apenas la capa más superficial. Una actualización del controlador, un cambio en el orden de ejecución del script de detección o una comprobación que omita JavaScript y examine directamente resultados de renderizado de bajo nivel y combinaciones de características del dispositivo puede dejar inútiles los cambios anteriores. El mantenimiento sigue siendo costoso y el beneficio continúa disminuyendo.
Además, en la práctica estas acciones suelen entrar justo en la zona que las condiciones de servicio de las plataformas definen como elusión de medidas técnicas de protección. Un script bien escrito no cambia la naturaleza de la acción por haber modificado unas cuantas propiedades.
La capa de red no puede resolverse desde el script
Aunque el entorno del navegador parezca coherente, la capa de red puede seguir identificando la sesión. Puede analizar si la IP pertenece a un centro de datos, un servidor en la nube o una red proxy; la reputación histórica del rango de IP y su ASN; la geolocalización; la densidad de solicitudes desde la misma IP; y si esa IP accede a varias cuentas o páginas en poco tiempo. Las Cookies, las Sessions y el estado de inicio de sesión enviados en las solicitudes también pueden correlacionarse.
Estos problemas no se solucionan dentro del script, sino en la capa del entorno: una salida separada para cada tarea, coherencia entre la región de salida y la región del entorno, y un ritmo de solicitudes controlable. En el aislamiento de múltiples tareas, capacidades como PurpleMark suelen actuar en esta capa, proporcionando a cada tarea un entorno de navegador y una salida de red independientes, con parámetros geográficos coherentes.
Orden práctico de diagnóstico cuando se bloquea el acceso
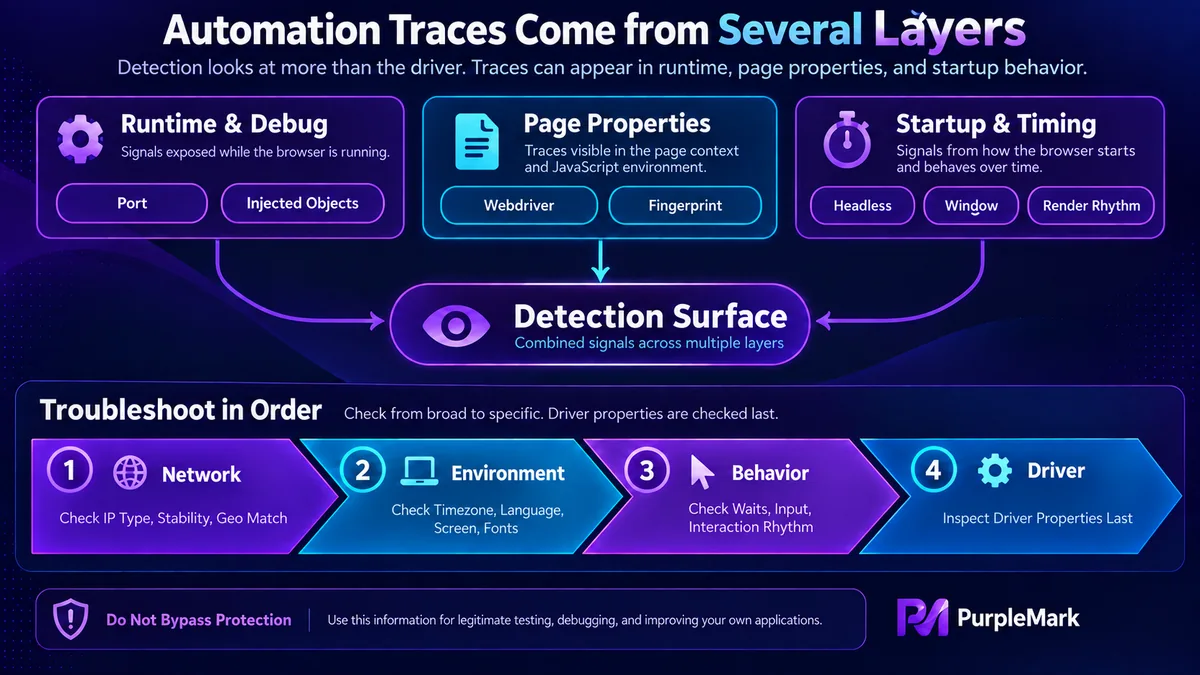
Un orden razonable es: primero revisar la capa de red y comprobar el tipo de IP, la estabilidad y la coherencia geográfica; después verificar que zona horaria, idioma, resolución y fuentes sean coherentes dentro del entorno; a continuación observar el ritmo del comportamiento, por ejemplo si las esperas son siempre fijas o si la entrada se completa de forma instantánea; y solo al final revisar las propiedades de automatización a nivel del controlador.
La razón es sencilla: los artefactos del controlador ya no son el foco principal de la detección. Colocarlos al principio del diagnóstico suele ser una pérdida de tiempo.
Límites
Las medidas técnicas pueden reducir la probabilidad de identificación, pero hay líneas que no deben cruzarse: respetar las reglas robots y las condiciones de servicio del sitio de destino, no recopilar información personal, no eludir medidas técnicas de protección, controlar la frecuencia de las solicitudes y no interferir con el funcionamiento normal del servicio.


