
เบราว์เซอร์ที่เปิดด้วย Selenium อาจแตกต่างจากการใช้งานทั่วไปในด้านพอร์ตดีบัก คุณสมบัติที่หน้าเว็บอ่านได้ และรูปแบบการเริ่มทำงาน บางส่วนปรับให้สอดคล้องกันได้อย่างสมเหตุผล แต่การพยายามซ่อนระบบอัตโนมัติเองนั้นเปราะบาง ไม่จำเป็น และมักไม่ได้ผลในระยะยาว
เมื่อใช้ Selenium ทำระบบอัตโนมัติ อาจเกิดกรณีที่ตรรกะของสคริปต์ถูกต้องแต่ยังไม่ได้ผลลัพธ์ที่ต้องการ หลายคนมักเริ่มจากการแก้พารามิเตอร์หนึ่งหรือสองค่า แต่สิ่งที่ทำให้ environment ดูผิดปกติจริง ๆ มักไม่ใช่สวิตช์เพียงตัวเดียว หากเป็นความแตกต่างหลายอย่างในหลายชั้น การแยกแต่ละชั้นออกมาดูช่วยให้เห็นว่าอะไรควรตั้งค่า และอะไรทำไปแล้วก็แทบไม่เกิดประโยชน์
พอร์ตดีบักและร่องรอยใน runtime
วิธีที่ Selenium ควบคุมเบราว์เซอร์ทำให้เกิดร่องรอยหลักสองประเภท ประเภทแรกคือพอร์ตดีบักที่เบราว์เซอร์อาจเปิดเมื่อเริ่มทำงาน ซึ่งซอฟต์แวร์ภายนอกสามารถใช้ควบคุมหน้าได้ ประเภทที่สองคือองค์ประกอบเพิ่มเติมใน runtime environment เช่น global variables ที่มีคำนำหน้า cdc_ ซึ่ง driver ฉีดเข้าไป วัตถุ driver เพิ่มเติมบน window และบางส่วนของ object prototypes ที่ถูกแก้ไข
สิ่งเหล่านี้ไม่ได้มาจากหน้าเว็บ แต่มาจาก driver เอง หากเปิดเบราว์เซอร์ด้วยวิธีมาตรฐาน ร่องรอยเหล่านี้ก็จะอยู่ตรงนั้นไม่ว่าสคริปต์จะเขียนดีเพียงใด
คุณสมบัติที่หน้าเว็บอ่านได้
ร่องรอยอีกประเภทหนึ่งไม่ได้อยู่ใน driver แต่อยู่ใน JavaScript environment ที่หน้าเว็บอ่านได้ ตัวอย่างที่ถูกพูดถึงบ่อยที่สุดคือ navigator.webdriver
คุณสมบัตินี้มีค่าได้สามแบบ true หมายถึงเบราว์เซอร์กำลังถูกควบคุมโดยเครื่องมืออัตโนมัติ false หมายถึงไม่ได้ถูกควบคุม และ undefined หมายถึงไม่สามารถรับข้อมูลดังกล่าวได้ โดยทั่วไปเป็นเพราะเบราว์เซอร์ไม่ได้เปิดเผยคุณสมบัตินี้หรือมีการประมวลผลบางอย่าง ในการใช้งานของคนทั่วไปค่ามักเป็น false หรือ undefined ส่วน Selenium ที่เริ่มด้วยค่าปริยายจะเป็น true
นอกจากนี้ยังมีพารามิเตอร์อีกหลายอย่าง เช่น User-Agent ระบบปฏิบัติการและเวอร์ชันเบราว์เซอร์ ความละเอียดหน้าจอ เขตเวลา ภาษา Canvas, WebGL, AudioContext รายการฟอนต์ รุ่น GPU และจำนวนคอร์ CPU เมื่อนำมารวมกันก็คือสิ่งที่มักเรียกว่า browser fingerprint อุปกรณ์ของผู้ใช้จริงมีระบบ ซอฟต์แวร์ และพฤติกรรมต่างกัน จึงมี fingerprints ที่กระจายตามธรรมชาติ ในทางกลับกัน เบราว์เซอร์ที่ทำงานด้วย default automation configuration อาจสร้างชุดค่าที่คล้ายกันมาก ทำให้จัดเข้า pattern ที่รู้จักได้ง่ายขึ้น
ความแตกต่างจากวิธีเริ่มทำงานและจังหวะการเรนเดอร์
ประเภทที่สามไม่ได้อยู่ที่คุณสมบัติใดคุณสมบัติหนึ่ง แต่เกิดจากรูปแบบการเริ่มและการเรนเดอร์ของเบราว์เซอร์โดยรวม
การเริ่มด้วย automation flags การทำงานใน headless mode ขนาดหน้าต่างไม่สอดคล้องกับพารามิเตอร์หน้าจอ การจับคู่ font rendering กับ graphics driver ที่ไม่สมเหตุผล หรือเวลาจาก page load จนโต้ตอบได้มีรูปแบบสม่ำเสมอเกินไป หากดูแยกกันแต่ละอย่างไม่ถือเป็นหลักฐาน แต่เมื่อรวมกันอาจทำให้ environment ดูไม่เหมือนอุปกรณ์ที่คนจริงใช้งาน
Headless เป็นตัวอย่างที่ชัดเจน Chrome รุ่นใหม่ใน headless mode ใกล้เคียงเบราว์เซอร์ปกติมากกว่าสมัยก่อนมาก แต่เมื่อเทียบกับ regular mode ก็ยังมีโอกาสแสดง automation characteristics ได้ง่ายกว่า โดยเฉพาะบนไซต์ที่มี risk controls เข้มงวด
สิ่งที่ตั้งค่าได้อย่างสมเหตุผล
เขตเวลา ภาษา ความละเอียดหน้าจอ และรายการฟอนต์ไม่ใช่สิ่งที่มีเฉพาะในระบบอัตโนมัติ อุปกรณ์จริงก็แตกต่างกันอยู่แล้ว สิ่งสำคัญคือความสอดคล้องภายใน: เขตเวลาควรตรงกับภูมิภาคของ network exit ภาษาเหมาะกับภูมิภาคที่ใช้งาน และความละเอียดไม่ขัดกับ hardware profile
พูดง่าย ๆ เป้าหมายไม่ใช่ทำให้ environment ดูพิเศษ แต่ทำให้ข้อมูลภายในสอดคล้องกัน หากอุปกรณ์ดูเหมือนเชื่อมต่อจากเยอรมนี แต่เบราว์เซอร์รายงานเขตเวลา U.S. West Coast ระบบมีเพียงภาษาอังกฤษ และความละเอียดหน้าจอดูเหมือน virtual display ทั่วไป เพียงชุดค่านี้ก็โดดเด่นพอแล้ว
นี่จึงเป็นเหตุผลว่าทำไมการตั้งค่า environment ควรถูกเก็บในรูปแบบที่คงอยู่ระยะยาว การเปลี่ยนเขตเวลาวันนี้แล้วลืมภาษาในวันถัดไป อาจสร้างความไม่สอดคล้องมากกว่าการไม่เปลี่ยนอะไรเลย
สิ่งที่พยายามซ่อนระบบอัตโนมัติเอง และเหตุผลที่ไม่คุ้ม
อีกกลุ่มหนึ่งมุ่งแก้ร่องรอยโดยตรง เช่น ลบ navigator.webdriver ลบ variables ที่ driver ฉีดเข้าไป ซ่อน driver objects หรือทำให้ฝ่ายตรวจจับอ่าน automation status ไม่ได้
ปัญหาคือวิธีเหล่านี้เปลี่ยนเพียงพื้นผิว ไม่ได้เปลี่ยนพฤติกรรมพื้นฐาน ระบบตรวจจับไม่ได้ดูเพียง property เดียวมานานแล้ว และการอ่าน attributes เป็นเพียงชั้นบนสุดเท่านั้น การอัปเดต driver การเปลี่ยนลำดับการทำงานของ detection script หรือการตรวจที่ข้าม JavaScript แล้วดู low-level rendering results กับชุด device characteristics โดยตรง อาจทำให้การแก้ไขเดิมใช้ไม่ได้ทันที ต้นทุน maintenance ยังสูง ขณะที่ประโยชน์ลดลงเรื่อย ๆ
ในทางปฏิบัติ การกระทำลักษณะนี้มักอยู่ตรงบริเวณที่ terms of service ของแพลตฟอร์มระบุว่าเป็นการหลีกเลี่ยง technical protection measures ต่อให้เขียนสคริปต์สะอาดเพียงใด ลักษณะของการกระทำก็ไม่ได้เปลี่ยนไปเพราะแก้ properties บางตัว
ชั้นเครือข่ายแก้ไม่ได้จากสคริปต์
แม้ browser environment จะดูสอดคล้อง ชั้นเครือข่ายก็ยังสามารถระบุ session ได้ อาจพิจารณาว่า IP เป็นของ data center, cloud server หรือ proxy network หรือไม่ ดู historical reputation และ ASN ของช่วง IP ตำแหน่งทางภูมิศาสตร์ ความหนาแน่นของ requests จาก IP เดียวกัน และดูว่า IP เดียวเข้าถึงหลายบัญชีหรือหลายหน้าในช่วงเวลาสั้น ๆ หรือไม่ Cookies, Sessions และ login state ที่มากับ requests ก็อาจถูกนำมาเชื่อมโยงกันได้
เรื่องเหล่านี้แก้ในสคริปต์ไม่ได้ ต้องจัดการใน environment layer: ใช้ network exit แยกสำหรับแต่ละ task ให้ exit region ตรงกับ environment region และควบคุม request pacing ได้ สำหรับการแยกหลาย task ความสามารถอย่าง PurpleMark มักทำงานในชั้นนี้ โดยให้แต่ละ task มี browser environment และ network exit อิสระ พร้อมรักษา geographic parameters ให้สอดคล้องกัน
ลำดับตรวจสอบเมื่อถูกบล็อกจริง
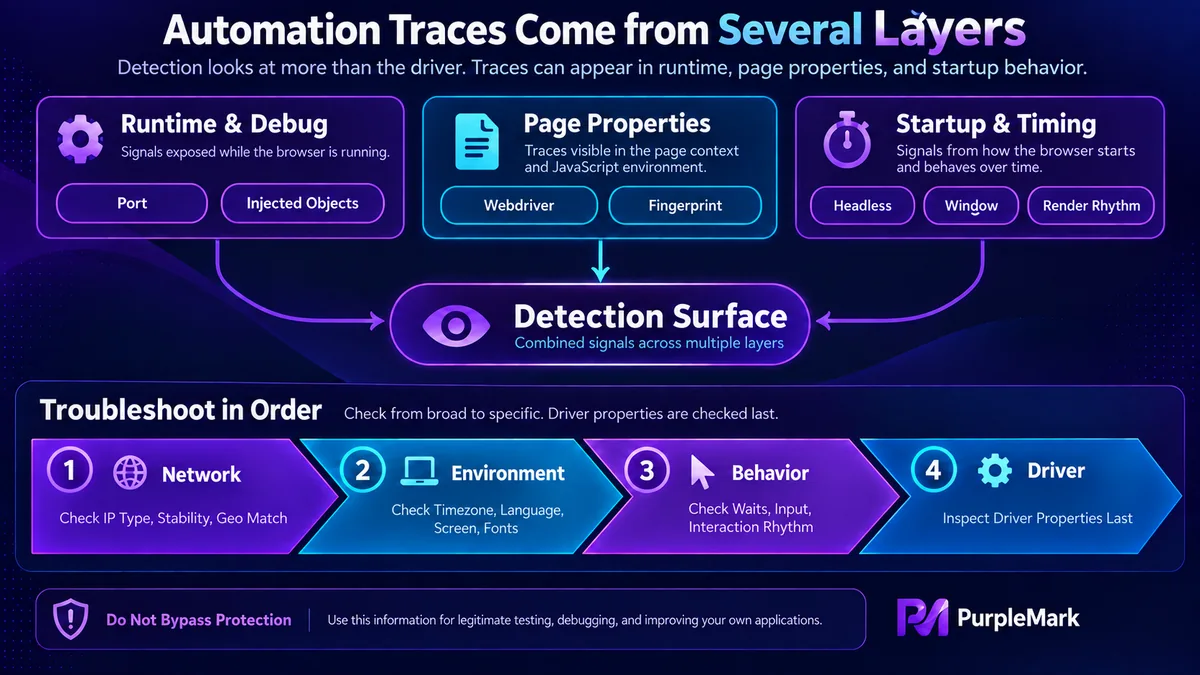
ลำดับที่เหมาะสมคือ เริ่มจากชั้นเครือข่ายเพื่อตรวจชนิด IP ความเสถียร และ geographic consistency จากนั้นตรวจความสอดคล้องภายใน environment ระหว่างเขตเวลา ภาษา ความละเอียด และฟอนต์ ต่อมาดู behavior timing เช่น waits เป็นค่าคงที่หรือไม่ หรือ input เสร็จทันทีเกินไป แล้วค่อยตรวจ driver-level automation properties เป็นขั้นตอนสุดท้าย
เหตุผลง่าย ๆ คือ driver-level artifacts ไม่ใช่จุดหลักของการตรวจจับอีกต่อไป การเอาส่วนนี้ไว้เป็นขั้นแรกของ troubleshooting มักเสียเวลาโดยเปล่าประโยชน์
ขอบเขต
มาตรการทางเทคนิคอาจลดโอกาสถูกระบุได้ แต่มีเส้นที่ไม่ควรข้าม: ปฏิบัติตามกฎ robots และ terms of service ของไซต์เป้าหมาย ไม่เก็บข้อมูลส่วนบุคคล ไม่หลีกเลี่ยง technical protection measures ควบคุมความถี่ของ requests และไม่รบกวนการทำงานปกติของบริการอีกฝ่าย


