
Seleniumで起動したブラウザには、デバッグポート、ページから読めるプロパティ、起動方法に違いが残ることがあります。整合性のために合理的に設定できる項目がある一方、自動化そのものを隠す試みは不要で壊れやすく、効果も持続しにくいものです。
Seleniumで自動化を実行していると、スクリプトのロジックに問題がなくても期待した結果が得られないことがあります。多くの場合、最初に一つか二つのパラメータを変更したくなりますが、環境を目立たせる原因は単独のスイッチではありません。複数の層にまたがる違いが重なることで特徴が生まれます。層ごとに分けて考えると、何を設定する価値があり、何をしてもあまり意味がないのかが見えやすくなります。
デバッグポートとランタイム上の痕跡
Seleniumがブラウザを制御する方法によって、主に2種類の痕跡が残ります。一つは、ブラウザ起動時に開かれるデバッグポートです。外部ソフトウェアはこのポートを通じてページを操作できます。もう一つはランタイム環境に増える要素で、ドライバが注入するcdc_接頭辞付きのグローバル変数、window上に追加されるドライバオブジェクト、一部のオブジェクトプロトタイプの変更などです。
これらの出所はWebページではなくドライバ自体です。標準的な方法で起動する限り、スクリプトの品質とは関係なく存在します。
ページから読み取れるプロパティ
別の種類の痕跡はドライバ側ではなく、ページから読めるJavaScript環境にあります。最もよく言及されるのがnavigator.webdriverです。
このプロパティには3つの状態があります。trueはブラウザが自動化ツールによって制御されていることを示し、falseは制御されていないことを示します。undefinedは関連情報を取得できない状態で、通常はブラウザがそのプロパティを公開していないか、何らかの処理が行われている場合です。通常の人による閲覧ではfalseまたはundefinedで、Seleniumのデフォルト起動ではtrueになります。
その周辺にはさらに多くのパラメータがあります。User-Agent、OSとブラウザのバージョン、画面解像度、タイムゾーン、言語、Canvas、WebGL、AudioContext、フォント一覧、GPUモデル、CPUコア数などです。これらを組み合わせたものが一般にブラウザフィンガープリントと呼ばれます。実際のユーザーはシステム、ソフトウェア、利用習慣が異なるため、フィンガープリントも自然に分散します。一方、デフォルト設定で動く自動化ブラウザは似通った組み合わせになりやすく、既知のパターンとしてまとめられやすくなります。
起動方法とレンダリングタイミングによる違い
3つ目は単一のプロパティではなく、起動方法やレンダリング全体から生じる違いです。
自動化フラグ付きでの起動、headlessモード、ウィンドウサイズと画面パラメータの不一致、フォントレンダリングとグラフィックドライバの不自然な組み合わせ、ページ読み込みから操作可能になるまでの時間が均一すぎることなどは、単独では証拠になりません。しかし複数が重なると、実際の人が使っている環境らしくない特徴になります。
Headlessは典型例です。新しいChromeのheadlessモードは数年前より通常のブラウザにかなり近づいていますが、それでも通常モードと比べると自動化の特徴が現れやすく、特に厳しいリスク管理を行うサイトでは差が目立つことがあります。
合理的に設定できる範囲
タイムゾーン、言語、画面解像度、フォント一覧は自動化だけに存在する要素ではありません。実際の端末でも自然に違いがあります。重要なのは内部の整合性です。タイムゾーンはネットワーク出口の地域と合い、言語は通常利用する地域と合い、解像度はハードウェアの特徴と矛盾しないことが必要です。
要するに、環境を特別に見せることが目的ではなく、内部で話が通る状態にすることが目的です。ドイツからアクセスしているように見える端末なのに、ブラウザが米国西海岸のタイムゾーンを返し、システム言語が英語だけで、画面解像度も典型的な仮想ディスプレイの値なら、その組み合わせだけで十分に不自然です。
そのため、環境設定は長期的に保持できる仕組みに保存するのが望ましいです。今日タイムゾーンだけ変え、明日は言語設定を忘れるような状態は、何も変更しない場合より整合性を崩します。
自動化そのものを隠す方法と、勧められない理由
別のアプローチは痕跡自体を直接消そうとするものです。navigator.webdriverを消す、ドライバが注入した変数を削除する、ドライバオブジェクトを隠すなどして、自動化状態を検出側から読めないようにします。
問題は、こうした方法が表面だけを変える点にあります。検出はすでに一つの項目を見るだけではなく、属性の読み取りは最も表面的な層にすぎません。ドライバが更新されたり、検出スクリプトの実行順が変わったり、JavaScriptを経由せず低レベルのレンダリング結果や端末特性の組み合わせを見る方式になったりすれば、以前の変更は簡単に効かなくなります。保守コストは高いままなのに、得られる効果は下がり続けます。
さらに実務上は、こうした操作がプラットフォームの利用規約で技術的保護措置の回避とされる領域に入りやすい点もあります。いくつかのプロパティを変更したからといって、行為の性質が変わるわけではありません。
ネットワーク層はスクリプトでは解決できない
ブラウザ環境に問題が見つからなくても、ネットワーク層から識別される可能性は残ります。IPがデータセンター、クラウドサーバー、プロキシネットワークのどれに属するか、そのIP帯の過去の評価やASN、位置情報、同一IPからのリクエスト密度、短時間に複数アカウントや複数ページへアクセスしているかなどが見られます。リクエストに含まれるCookie、Session、ログイン状態も関連付けに使われることがあります。
これらはスクリプト内では解決できず、環境レイヤーで扱う必要があります。タスクごとに出口を分け、出口の地域と環境の地域を合わせ、リクエストのペースを制御できる状態にします。複数タスクを分離する場合、PurpleMarkのような機能は通常この層で働き、各タスクに独立したブラウザ環境とネットワーク出口を割り当てながら、地域パラメータの整合性を保ちます。
実際にブロックされたときの確認順序
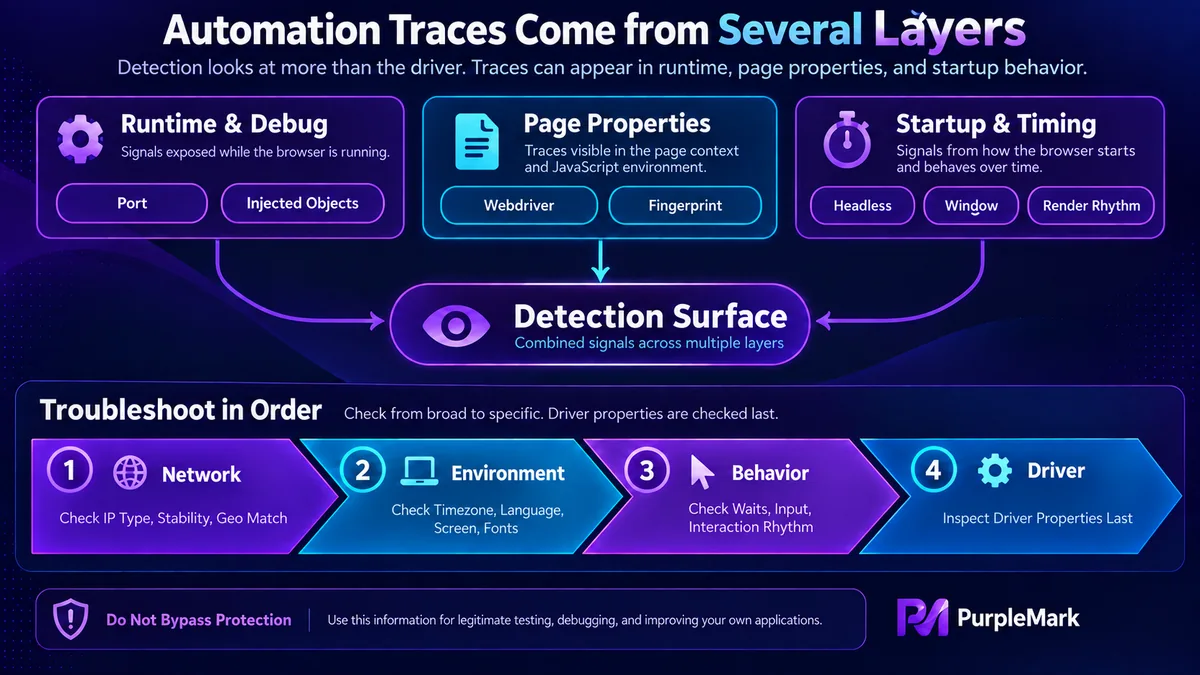
おおまかな順序は、まずネットワーク層でIPの種類、安定性、地域の整合性を確認し、次に環境内部でタイムゾーン、言語、解像度、フォントが矛盾していないかを見ます。その後、待機時間が常に固定されていないか、入力が瞬時に終わっていないかなど行動のタイミングを確認し、最後にドライバレベルの自動化プロパティを確認します。
理由は単純です。ドライバ層の痕跡はすでに検出の中心ではありません。そこを最初に調べても、時間を浪費する可能性が高いからです。
境界
技術的な対策で識別される可能性を下げることはできますが、越えるべきでない線があります。対象サイトのrobotsルールと利用規約を守ること、個人情報を収集しないこと、技術的保護措置を回避しないこと、リクエスト頻度を制御すること、相手のサービスの通常運用に影響を与えないことです。


