
Navegadores iniciados pelo Selenium podem apresentar diferenças nas portas de depuração, nas propriedades que a página consegue ler e no modo de inicialização. Algumas configurações são razoáveis, enquanto tentar esconder a própria automação é frágil, desnecessário e frequentemente ineficaz.
Ao executar automação com Selenium, pode acontecer de a lógica do script estar correta e ainda assim o resultado esperado não aparecer. A primeira reação costuma ser alterar um ou dois parâmetros, mas o que realmente torna o ambiente identificável geralmente não é um único ajuste. Normalmente é uma combinação de diferenças em várias camadas. Separar essas camadas ajuda a entender o que vale a pena configurar e o que tende a não trazer resultado.
Portas de depuração e artefatos de runtime
A forma como o Selenium controla o navegador deixa dois tipos de rastros. Primeiro, o navegador pode abrir uma porta de depuração durante a inicialização, permitindo que software externo assuma o controle da página. Segundo, o ambiente de runtime pode conter elementos adicionais, como variáveis globais com prefixo cdc_ injetadas pelo driver, objetos extras do driver em window e partes modificadas de alguns protótipos de objetos.
Esses elementos não vêm da página web, mas do próprio driver. Quando o navegador é iniciado da maneira padrão, eles ficam presentes independentemente de quão bem o script foi escrito.
Propriedades que a página consegue ler
Outro tipo de rastro não está no driver, mas no ambiente JavaScript acessível à página. O exemplo mais citado é navigator.webdriver.
Essa propriedade pode ter três valores. true significa que o navegador está sendo controlado por uma ferramenta de automação, false significa que não está, e undefined significa que essa informação não está disponível, geralmente porque o navegador não expõe a propriedade ou porque ela foi alterada. Em uma navegação humana normal, o valor costuma ser false ou undefined; no início padrão do Selenium, é true.
Há ainda um conjunto maior de parâmetros: User-Agent, sistema operacional e versão do navegador, resolução da tela, fuso horário, idioma, Canvas, WebGL, AudioContext, lista de fontes, modelo da GPU e número de núcleos da CPU. Juntos, eles formam o que normalmente se chama de impressão digital do navegador. Usuários reais apresentam impressões naturalmente variadas porque seus sistemas, softwares e hábitos são diferentes. Já navegadores executados com configurações padrão de automação podem gerar combinações muito parecidas, facilitando o agrupamento em padrões conhecidos.
Diferenças causadas pelo modo de inicialização e pelo tempo de renderização
A terceira categoria não está ligada a uma única propriedade, mas às diferenças gerais causadas pela forma de iniciar e renderizar o navegador.
Iniciar com flags de automação, executar em modo headless, usar tamanho de janela incompatível com os parâmetros da tela, combinar de forma incoerente renderização de fontes e driver gráfico ou apresentar tempos excessivamente uniformes entre o carregamento e a interatividade não é prova isoladamente. No entanto, a combinação desses elementos pode formar um ambiente pouco parecido com o de um usuário real.
Headless é um exemplo típico. O modo headless das versões recentes do Chrome está muito mais próximo de um navegador normal do que há alguns anos, mas ainda pode revelar características de automação com mais facilidade do que o modo convencional, principalmente em sites com controles de risco rigorosos.
O que pode ser configurado de forma razoável
Fuso horário, idioma, resolução de tela e lista de fontes não são exclusivos da automação. Dispositivos reais também variam naturalmente nesses pontos. O que importa é a consistência interna: o fuso horário deve combinar com a região da saída de rede, o idioma com a região de uso habitual e a resolução não deve contradizer o perfil de hardware.
Em outras palavras, o objetivo não é fazer o ambiente parecer especial, mas fazê-lo ser coerente. Se um dispositivo parece acessar a partir da Alemanha, mas o navegador informa o fuso da costa oeste dos EUA, o sistema usa apenas inglês e a resolução de tela parece típica de uma tela virtual, essa combinação já é suficientemente incomum.
Por isso, as configurações do ambiente funcionam melhor quando são armazenadas de forma persistente. Alterar o fuso horário hoje e esquecer o idioma amanhã pode criar mais inconsistência do que não mudar nada.
O que tenta esconder a própria automação e por que não vale a pena
Outra classe de técnicas mira diretamente os rastros: remover navigator.webdriver, apagar variáveis injetadas pelo driver, esconder objetos do driver ou impedir de outras maneiras que o detector leia o estado de automação.
O problema é que essas técnicas alteram a superfície, não o comportamento subjacente. A detecção há muito tempo deixou de observar apenas uma propriedade; ler atributos é somente a camada mais superficial. Uma atualização do driver, uma mudança na ordem de execução do script de detecção ou um detector que ignore o JavaScript e examine diretamente resultados de renderização de baixo nível e combinações de características do dispositivo pode invalidar ajustes anteriores. O custo de manutenção continua alto enquanto o benefício segue diminuindo.
Além disso, na prática, esse tipo de ação frequentemente cai exatamente na área que os termos de serviço das plataformas descrevem como contorno de medidas técnicas de proteção. Um script bem escrito não muda a natureza da ação só porque algumas propriedades foram modificadas.
A camada de rede não pode ser resolvida pelo script
Mesmo que o ambiente do navegador pareça consistente, a camada de rede ainda pode identificar a sessão. Ela pode considerar se o IP pertence a um data center, servidor em nuvem ou rede proxy; a reputação histórica e o ASN da faixa de IP; a geolocalização; a densidade de solicitações do mesmo IP; e se esse IP acessa várias contas ou páginas em pouco tempo. Cookies, Sessions e o estado de login enviados nas solicitações também podem ser correlacionados.
Esses problemas não podem ser resolvidos dentro do script. Precisam ser tratados na camada do ambiente: uma saída separada por tarefa, alinhamento entre a região da saída e a região do ambiente e um ritmo de solicitações controlável. Em isolamento de múltiplas tarefas, recursos como os do PurpleMark normalmente atuam nessa camada, fornecendo a cada tarefa um ambiente de navegador e uma saída de rede independentes, mantendo consistentes os parâmetros geográficos.
Ordem prática de diagnóstico quando o acesso é bloqueado
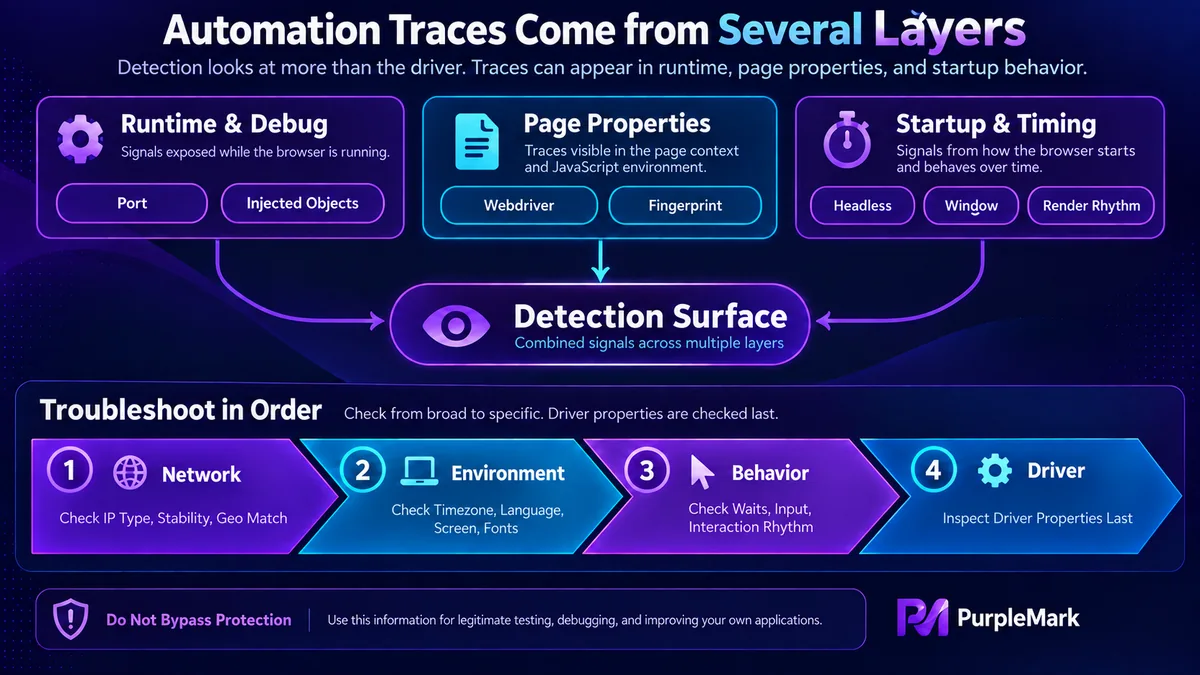
Uma ordem razoável é: primeiro verificar a camada de rede, observando tipo de IP, estabilidade e consistência geográfica; depois conferir se o ambiente é internamente coerente em fuso horário, idioma, resolução e fontes; em seguida analisar o ritmo do comportamento, como esperas sempre fixas ou entradas concluídas instantaneamente; e só por último revisar as propriedades de automação no nível do driver.
A razão é simples: artefatos do driver já não são o principal foco da detecção. Colocá-los no início do diagnóstico normalmente significa gastar tempo à toa.
Limites
Medidas técnicas podem reduzir a probabilidade de identificação, mas algumas linhas não devem ser ultrapassadas: respeite as regras de robots e os termos de serviço do site de destino, não colete informações pessoais, não contorne medidas técnicas de proteção, controle a frequência das solicitações e não prejudique o funcionamento normal do serviço.


