
Um script pode funcionar bem localmente e, depois do deploy, encontrar CAPTCHA, erros 403 ou falhas de login. Em geral, a plataforma não reconhece uma ferramenta específica; ela avalia diferenças observáveis da automação no protocolo, runtime, fingerprint, rede e tempo de comportamento.
Um cenário se repete com frequência: o script funciona muito bem localmente, mas depois do deploy começa a encontrar verificações humanas, erros 403 ou falhas de login. A primeira reação costuma ser pensar que a ferramenta foi reconhecida.
Na prática, as plataformas raramente se concentram em identificar qual ferramenta específica você usou. Elas avaliam a diferença entre esse acesso e o acesso de um usuário real. O Playwright controla o navegador; se o ambiente que ele inicia for claramente diferente do navegador que uma pessoa usa no dia a dia, o tráfego pode ser classificado como automatizado. Essas diferenças aparecem em várias camadas, e analisá-las separadamente ajuda a localizar a causa.
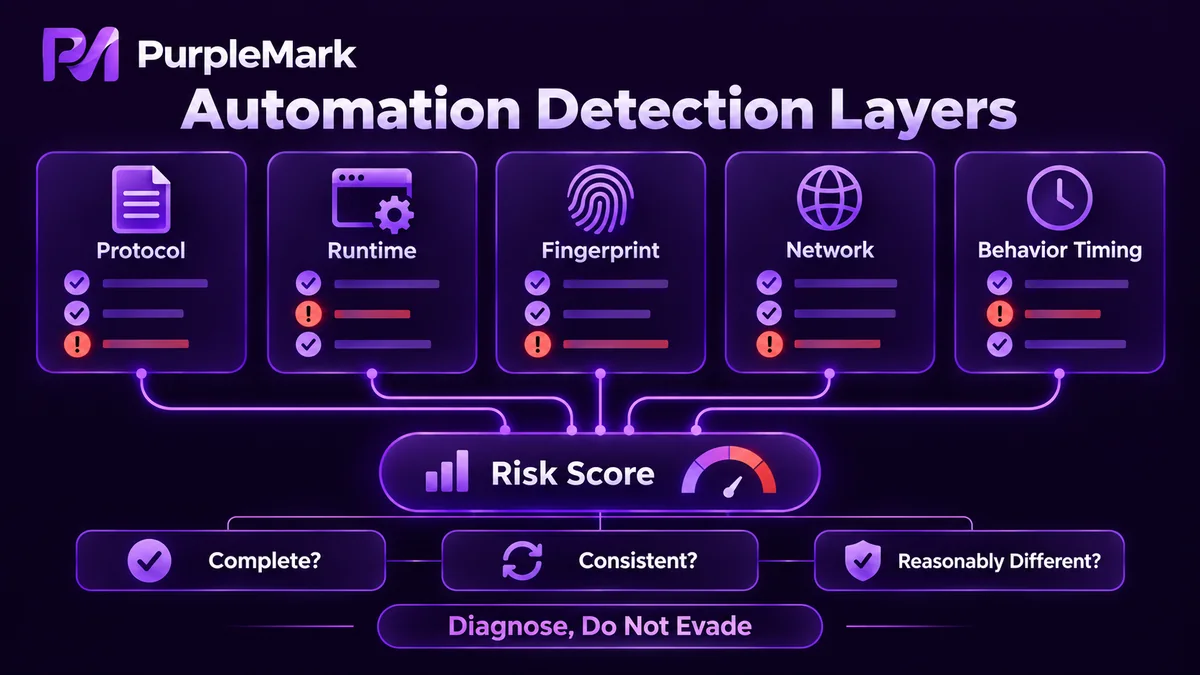
A camada de protocolo fala antes mesmo da renderização
Na camada de protocolo, não é o conteúdo da página que aparece, mas o formato da própria requisição: a combinação dos cabeçalhos, a versão do navegador e a arquitetura da plataforma em UA Client Hints, além da ordem dos parâmetros durante o estabelecimento da conexão.
Ambientes automatizados muitas vezes parecem limpos ou uniformes demais nesses pontos. Cabeçalhos esperados podem estar ausentes, ou todos os valores podem permanecer tão fixos que não lembram uma máquina usada por uma pessoa durante muito tempo. Essa camada tem baixo custo de avaliação e permite chegar a uma conclusão antes da renderização da página, por isso é amplamente usada.
Variáveis de runtime formam a segunda camada
Depois que os scripts da página começam a rodar, outro conjunto de variáveis do ambiente pode ser lido. Pelo padrão WebDriver, navigator.webdriver normalmente retorna true quando o navegador está sendo controlado por uma ferramenta de automação. Sinais do mesmo tipo incluem flags de automação nos argumentos de inicialização, a existência de window.chrome, a integridade de navigator.plugins e navigator.permissions, o uso de modo headless e listas vazias de plugins ou extensões.
Navegadores reais normalmente trazem alguns itens padrão, então uma lista vazia pode se tornar uma característica por si só. Os primeiros métodos de detecção se concentravam muito nessa camada porque ela era fácil de observar. Hoje, poucas plataformas olham apenas uma propriedade; normalmente avaliam vários valores em conjunto.
O fingerprint verifica coerência, não valores isolados
Em seguida vêm os parâmetros do dispositivo: resultados de renderização de Canvas e WebGL, diferenças no processamento do AudioContext, lista de fontes, parâmetros de tela, fuso horário, idioma e informações de hardware. Separadamente, nenhum desses valores precisa ser problemático; juntos, eles formam um perfil de dispositivo relativamente estável.
Dois padrões podem parecer suspeitos. Primeiro, os parâmetros podem não combinar entre si — por exemplo, a renderização pode sugerir uma classe de GPU enquanto o conjunto de fontes parece vir de outro sistema operacional. Segundo, vários ambientes podem ser completamente idênticos. Se todas as tarefas começam com a mesma configuração, os fingerprints também serão iguais. A plataforma não vê cem dispositivos, mas o mesmo dispositivo acessando cem vezes.
Saída de rede e geografia são restrições rígidas
Os fatores de rede têm pouca relação com o navegador em si: se o IP pertence a um data center ou a uma conexão residencial, se o endereço proxy foi muito abusado, se o ASN pertence a um provedor de nuvem ou a uma operadora, se a configuração DNS corresponde à região do IP e se o IP muda frequentemente entre países.
Uma requisição com fuso horário dos Estados Unidos e saída de rede na Alemanha pode ser destacada sem nenhuma técnica avançada. Contradições geográficas estão entre as inconsistências mais baratas e fáceis de detectar em todo o sistema.
O tempo de comportamento se acumula aos poucos
O comportamento humano é irregular: pode haver uma pequena pausa antes de um clique, a velocidade de digitação varia e às vezes a pessoa volta para corrigir algo. Scripts tendem a seguir um ritmo preciso e repetitivo, caminhos de navegação fixos, não executam ações fora do objetivo e geram uma densidade de requisições claramente maior do que a de uma pessoa.
Os métodos de avaliação continuaram mudando nos últimos dois anos. Em 2026, alguns fornecedores de proteção lançaram mecanismos de verificação comportamental contínua que deixaram de tomar uma única decisão na primeira visita. Em vez disso, coletam durante toda a sessão movimentos do mouse, ritmo de cliques, trajetórias de rolagem e tempo de permanência na página, enviando os dados ao servidor em tempo real para pontuação de risco. Atualizar a página ou seguir para a próxima não zera os sinais de comportamento já acumulados; eles continuam se somando. Isso significa que as características de um único carregamento já não bastam — comportamento é um processo.
Por que as plataformas tratam essas diferenças como sinais de risco
Do ponto de vista da plataforma, a questão não é qual ferramenta o visitante usou, mas se o acesso parece o uso normal do serviço por uma pessoa real. Registros de spam, scraping em massa e requisições abusivas geram custos; por isso, uma contradição em qualquer dimensão pode elevar a pontuação de risco, e várias contradições juntas ficam ainda mais evidentes.
Por outro lado, simplesmente apagar características também não é o caminho. Dispositivos reais têm fingerprints completos e internamente coerentes; um fingerprint do qual partes foram removidas intencionalmente também pode parecer anormal. Um critério mais próximo da realidade envolve três perguntas: as características estão completas, os parâmetros são coerentes entre si e existem diferenças razoáveis entre ambientes distintos?
Atribuir a causa é diferente de contornar proteção
Separar as causas até esse nível serve para descobrir onde está o problema, não para explicar como contornar alguma proteção. Reduzir tecnicamente a chance de detecção não concede permissão para coletar dados ou automatizar um serviço. Os limites são claros: respeitar as regras de robots e os termos de serviço do site alvo, não coletar informações pessoais, não contornar medidas técnicas de proteção, controlar a frequência das requisições e não afetar a operação normal do serviço. Essa regra independe da solução técnica, mas tem a maior prioridade.


