
ស្គ្រីបអាចដំណើរការល្អនៅក្នុងម៉ាស៊ីនមូលដ្ឋាន ប៉ុន្តែបន្ទាប់ពីដាក់ឱ្យប្រើអាចជួប CAPTCHA, 403 ឬបរាជ័យចូលប្រព័ន្ធ។ ជាទូទៅ វេទិកាមិនស្គាល់ឧបករណ៍ជាក់លាក់មួយទេ ប៉ុន្តែវាវាយតម្លៃភាពខុសគ្នាដែលអាចសង្កេតបាននៅថ្នាក់ពិធីការ runtime fingerprint បណ្តាញ និងអាកប្បកិរិយា។
ស្ថានការណ៍មួយកើតឡើងជាញឹកញាប់៖ ស្គ្រីបដំណើរការល្អនៅលើម៉ាស៊ីនមូលដ្ឋាន ប៉ុន្តែបន្ទាប់ពីដាក់ឱ្យប្រើលើអ៊ីនធឺណិត វាចាប់ផ្តើមជួបការផ្ទៀងផ្ទាត់ថាជាមនុស្ស កំហុស 403 ឬការចូលប្រព័ន្ធបរាជ័យ។ ប្រតិកម្មដំបូងជាទូទៅគឺគិតថាឧបករណ៍ដែលបានប្រើត្រូវបានស្គាល់។
ប៉ុន្តែវេទិកាមានតិចណាស់ដែលព្យាយាមកំណត់ឧបករណ៍ជាក់លាក់ដែលអ្នកបានប្រើ។ អ្វីដែលវាវាយតម្លៃគឺភាពខុសគ្នារវាងការចូលប្រើនេះ និងការចូលប្រើរបស់អ្នកប្រើពិត។ Playwright គ្រប់គ្រង browser; ប្រសិនបើ environment ដែលវាបើកខុសយ៉ាងច្បាស់ពី browser ដែលមនុស្សប្រើជាទូទៅ ការចូលប្រើអាចត្រូវបានចាត់ថ្នាក់ថាជា automation។ ភាពខុសគ្នាទាំងនេះស្ថិតនៅច្រើនស្រទាប់ ហើយការមើលវាតាមស្រទាប់ធ្វើឱ្យងាយស្រួលរកមូលហេតុ។
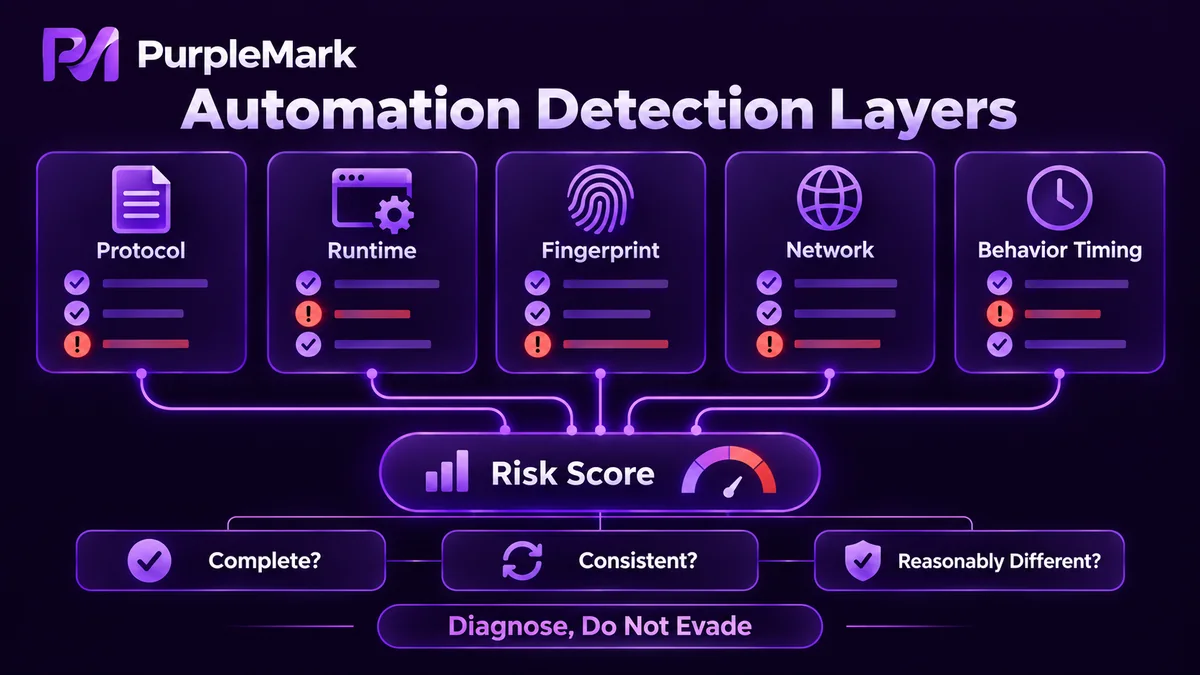
ស្រទាប់ពិធីការបង្ហាញសញ្ញាមុនពេលទំព័រត្រូវបាន render
នៅស្រទាប់ពិធីការ អ្វីដែលមើលឃើញមិនមែនជាខ្លឹមសារទំព័រ ប៉ុន្តែជាទម្រង់របស់ request ខ្លួនវា៖ ការរួមបញ្ចូល request headers, browser version និង platform architecture ក្នុង UA Client Hints និងលំដាប់ parameters នៅពេលបង្កើត connection។
Automation environments ជាញឹកញាប់មើលទៅស្អាតពេក ឬស្មើគ្នាពេកនៅចំណុចទាំងនេះ។ Header ដែលគួរតែមានអាចបាត់ ឬតម្លៃនីមួយៗអាចថេរពេក មិនស្រដៀងនឹងម៉ាស៊ីនដែលមនុស្សបានប្រើរយៈពេលយូរ។ ស្រទាប់នេះមានតម្លៃទាបក្នុងការវាយតម្លៃ ហើយអាចសម្រេចបានមុនពេលទំព័រ render ដូច្នេះវាត្រូវបានប្រើយ៉ាងទូលំទូលាយ។
Runtime variables ជាស្រទាប់ទីពីរ
បន្ទាប់ពី page scripts ចាប់ផ្តើមដំណើរការ អថេរ environment មួយក្រុមទៀតអាចអានបាន។ តាមស្តង់ដារ WebDriver នៅពេល browser ត្រូវបានគ្រប់គ្រងដោយ automation tool, navigator.webdriver ជាទូទៅត្រឡប់ true។ សញ្ញាប្រភេទដូចគ្នារួមមាន automation flags ក្នុង launch arguments, វត្តមានរបស់ window.chrome, ភាពពេញលេញរបស់ navigator.plugins និង navigator.permissions, ការដំណើរការ headless និងថាតើបញ្ជី plugins ឬ extensions ទទេឬអត់។
Browser ពិតជាទូទៅមានធាតុលំនាំដើមមួយចំនួន ដូច្នេះបញ្ជីទទេអាចក្លាយជាសញ្ញាដោយខ្លួនឯង។ វិធីសាស្ត្ររកឃើញដំបូងៗផ្តោតលើស្រទាប់នេះខ្លាំង ព្រោះងាយសង្កេត។ សព្វថ្ងៃ វេទិកាតិចណាស់មើលតែ property មួយ ហើយភាគច្រើនវាយតម្លៃតម្លៃទាំងនេះរួមគ្នា។
Fingerprint ពិនិត្យភាពស៊ីសង្វាក់ មិនមែនតម្លៃតែមួយ
បន្ទាប់មកគឺ parameters ខាង device៖ លទ្ធផល render របស់ Canvas និង WebGL, ភាពខុសគ្នានៃការដំណើរការ AudioContext, បញ្ជី fonts, screen parameters, time zone, language និង hardware information។ តម្លៃនីមួយៗដោយឡែកអាចមិនមានបញ្ហា ប៉ុន្តែពេលរួមគ្នាវាបង្កើត device profile ដែលមានស្ថិរភាពមួយ។
មានពីរចំណុចដែលអាចមើលទៅគួរឱ្យសង្ស័យ។ ទីមួយ parameters មិនត្រូវគ្នា ឧទាហរណ៍ rendering result មើលទៅមកពី GPU ប្រភេទមួយ ប៉ុន្តែ font set មើលទៅជារបស់ operating system ផ្សេង។ ទីពីរ environments ជាច្រើនដូចគ្នាទាំងស្រុង។ ប្រសិនបើ task ទាំងអស់ចាប់ផ្តើមពី configuration ដូចគ្នា fingerprints ក៏នឹងដូចគ្នា។ វេទិកានឹងមិនឃើញ device មួយរយទេ ប៉ុន្តែឃើញ device ដដែលចូលមួយរយដង។
Network egress និងព័ត៌មានភូមិសាស្ត្រជាលក្ខខណ្ឌរឹង
ចំណុចខាង network មិនសូវទាក់ទងនឹង browser ខ្លួនវាទេ៖ IP ជារបស់ data center ឬ residential connection, proxy address ធ្លាប់ត្រូវបានប្រើប្រាស់ខុសច្រើនឬទេ, ASN ជារបស់ cloud provider ឬ ISP, DNS configuration ត្រូវនឹងតំបន់ IP ឬទេ និង IP ផ្លាស់ប្តូរប្រទេសញឹកញាប់ឬអត់។
Request មួយដែល time zone បង្ហាញ United States ប៉ុន្តែ network egress នៅ Germany អាចត្រូវបានរកឃើញដោយមិនចាំបាច់ប្រើ advanced detection។ ភាពផ្ទុយគ្នាផ្នែកភូមិសាស្ត្រគឺជាចំណុចមួយដែលថោក និងងាយរកឃើញបំផុតក្នុងប្រព័ន្ធនេះ។
Behavioral timing ប្រមូលផ្តុំបន្តិចម្តងៗ
អាកប្បកិរិយារបស់មនុស្សមិនទៀងទាត់ទេ៖ អាចមានការផ្អាកខ្លីមុនចុច ល្បឿនវាយអក្សរប្រែប្រួល ហើយពេលខ្លះត្រឡប់ទៅកែ។ Script វិញជាញឹកញាប់មាន rhythm ត្រឹមត្រូវ និងធ្វើឡើងវិញ, មាន navigation path ថេរ, មិនធ្វើសកម្មភាពក្រៅពីគោលដៅ និងមាន request density ខ្ពស់ជាងមនុស្សយ៉ាងច្បាស់។
ក្នុងរយៈពេលពីរឆ្នាំចុងក្រោយ វិធីវាយតម្លៃក៏បន្តផ្លាស់ប្តូរ។ នៅឆ្នាំ 2026 អ្នកផ្គត់ផ្គង់ការការពារខ្លះបានដាក់ឱ្យប្រើ continuous behavioral-verification engines ដែលមិនសម្រេចតែម្តងនៅការចូលដំបូងទៀតទេ។ វាបន្តប្រមូល mouse movement, click rhythm, scroll trajectory និងពេលស្នាក់នៅលើ page ពេញមួយ session ហើយផ្ញើទិន្នន័យទៅ server ក្នុង real time ដើម្បីគណនា risk score។ ការធ្វើ refresh ឬទៅទំព័របន្ទាប់មិនលុបសញ្ញាអាកប្បកិរិយាដែលបានប្រមូលទេ; វាបន្តកើនឡើង។ នេះមានន័យថាលក្ខណៈពី page load តែមួយមិនគ្រប់គ្រាន់ទៀតទេ—អាកប្បកិរិយាគឺជាដំណើរការ។
ហេតុអ្វីវេទិកាចាត់ទុកភាពខុសគ្នាទាំងនេះជាសញ្ញាហានិភ័យ
តាមទស្សនៈវេទិកា គោលដៅមិនមែនកំណត់ថាអ្នកទស្សនាប្រើឧបករណ៍អ្វីទេ ប៉ុន្តែថាការចូលប្រើនេះស្រដៀងនឹងមនុស្សពិតប្រើសេវាធម្មតាឬអត់។ Spam registrations, bulk scraping និង abusive requests បង្កើតថ្លៃដើម ដូច្នេះភាពផ្ទុយគ្នានៅ dimension ណាមួយអាចបង្កើន risk score ហើយភាពផ្ទុយគ្នាច្រើនរួមគ្នានឹងកាន់តែច្បាស់។
ផ្ទុយទៅវិញ ការលុប features មិនមែនជាចម្លើយទេ។ Fingerprint របស់ device ពិតមានភាពពេញលេញ និងស៊ីសង្វាក់គ្នា; fingerprint ដែលត្រូវបានដកផ្នែកខ្លះចេញដោយចេតនាក៏អាចមើលទៅខុសប្រក្រតី។ លក្ខខណ្ឌដែលជិតនឹងការពិតជាងគេមានបី៖ features ពេញលេញឬទេ, parameters ស៊ីសង្វាក់គ្នាឬទេ និងមានភាពខុសគ្នាសមហេតុផលរវាង environments ផ្សេងៗឬទេ។
ការរកមូលហេតុ និងការរំលងការការពារ គឺខុសគ្នា
ការបំបែកមូលហេតុដល់កម្រិតនេះគឺដើម្បីដឹងថាបញ្ហាស្ថិតនៅទីណា មិនមែនដើម្បីបង្ហាញពីរបៀបរំលងការការពារ។ ការកាត់បន្ថយឱកាសត្រូវបានរកឃើញតាមបច្ចេកទេស មិនស្មើនឹងទទួលបានការអនុញ្ញាតឱ្យប្រមូលទិន្នន័យ ឬ automate សេវាទេ។ ព្រំដែនច្បាស់ណាស់៖ គោរព robots rules និង terms of service របស់ target site, មិនប្រមូល personal information, មិនរំលង technical protection measures, គ្រប់គ្រង request frequency និងមិនរំខានដល់ដំណើរការធម្មតារបស់សេវា។ គោលការណ៍នេះមិនអាស្រ័យលើដំណោះស្រាយបច្ចេកទេស ហើយមានអាទិភាពខ្ពស់បំផុត។


