
腳本在本機可以正常執行,上線後卻遇到人機驗證、403 或登入失敗。通常不是平台辨識出某個特定工具,而是自動化存取在協定層、執行階段、瀏覽器指紋、網路與行為時序上留下了可觀察的差異。
一個反覆出現的情境是:腳本在本機跑得很好,部署到線上後卻開始遇到人機驗證、403 或登入失敗。第一反應通常是工具本身被辨識出來了。
但平台很少專門去辨認你使用了哪一個工具。它判斷的是這次存取與真實使用者存取之間的差異。Playwright 負責控制瀏覽器;如果它啟動的環境與真人平常使用的瀏覽器環境差異明顯,就可能被歸類為自動化來源。這些差異分布在好幾個層次,逐層拆開看會更容易理解問題出在哪裡。
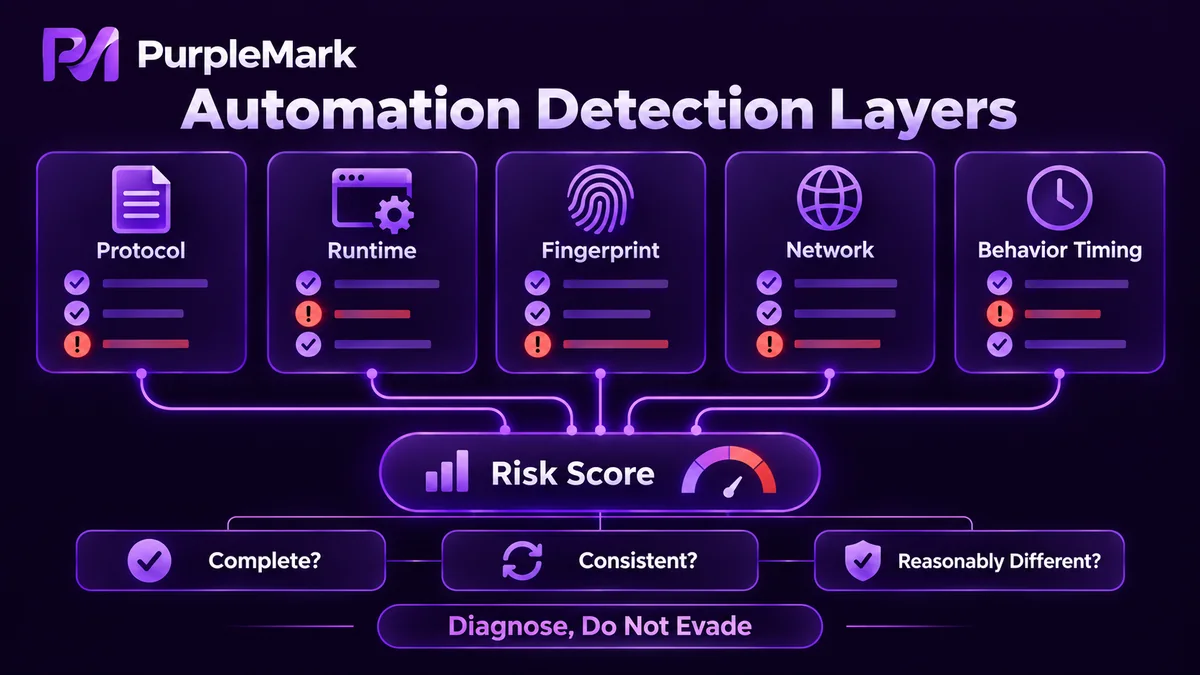
頁面還沒渲染,協定層就已經在說話
協定層能看到的不是頁面內容,而是請求本身的形態:request headers 的組合、UA Client Hints 裡的瀏覽器版本與平台架構,以及建立連線時 parameters 的順序。
自動化環境在這些地方常常顯得過於乾淨或過於整齊。該帶的 header 沒帶,或每個值都固定得不像一台被人長期使用過的電腦。這一層的判斷成本很低,頁面尚未渲染就能得出結論,因此被廣泛使用。
執行階段變數是第二層
頁面腳本開始執行後,又能讀到另一批環境變數。依照 WebDriver 標準,當瀏覽器由自動化工具控制時,navigator.webdriver 通常會回傳 true。同一類訊號還包括啟動參數中的自動化標記、window.chrome 是否存在、navigator.plugins 與 navigator.permissions 是否完整、是否以 headless 模式執行,以及 plugins 或 extensions 清單是否為空。
真實瀏覽器通常帶有若干預設項目,因此空清單本身就可能成為特徵。早期的偵測方法大多集中在這一層,因為它最容易被觀察。現在很少有平台只看單一屬性,而是把多個值一起評估。
指紋看的不是單一數值,而是彼此是否自洽
再往下是裝置側的 parameters:Canvas 與 WebGL 的渲染結果、AudioContext 的音訊處理差異、字型清單、螢幕參數、時區、語言與硬體資訊。這些值單獨看都不一定有問題,但組合起來就會形成相對穩定的裝置輪廓。
可疑的地方有兩種。第一,parameters 彼此對不上,例如渲染結果像某一類 GPU,但字型集合卻更像另一套作業系統。第二,一批 environments 完全相同;如果所有 task 都從同一套 configuration 啟動,fingerprints 就會一模一樣。這時平台看到的不是一百台裝置,而是同一台裝置造訪了一百次。
網路出口與地理資訊是硬限制
網路側的維度和瀏覽器本身關係不大:IP 屬於 data center 還是 residential connection、proxy address 是否曾被大量濫用、ASN 是 cloud provider 還是 ISP、DNS configuration 是否與 IP 地區一致,以及 IP 是否經常在不同國家之間跳動。
一個時區顯示 United States、但 network egress 落在 Germany 的請求,不需要任何 advanced detection 就能被挑出來。地理上的矛盾是整個系統裡成本最低、也最容易被發現的破綻之一。
行為時序會慢慢累積
真人的操作並不規律:點擊前會有短暫停頓,輸入速度有快有慢,偶爾還會回頭修改。腳本的節奏往往精確又重複,存取路徑固定,不會產生目標之外的動作,而且 request density 明顯高於人類。
這兩年判定方式還在持續變化。2026 年,有些防護供應商上線了持續型 behavioral-verification engines,不再只在第一次存取時判斷一次,而是在整個 session 中持續收集 mouse movement、click rhythm、scroll trajectory 與頁面停留時間,並以 real time 將資料送回 server 做 risk scoring。重新整理頁面或跳到下一頁時,已累積的行為特徵不會歸零,而會繼續疊加。這代表單次 page load 的特徵已經不夠,行為是一段持續的過程。
平台為什麼把這些差異視為風險訊號
站在平台的立場,它要區分的不是訪客用了什麼工具,而是這次存取是否像一個真實的人在正常使用服務。Spam registrations、bulk scraping 與 abusive requests 都會產生成本,因此任何一個維度出現矛盾都可能讓 risk score 上升,幾個維度的矛盾疊在一起時就更明顯。
反過來說,單純把特徵抹掉也不是方向。真實裝置的 fingerprint 是完整且自洽的;被刻意挖掉幾塊的 fingerprint 在風控眼中同樣可能顯得異常。更接近事實的判斷標準有三個:特徵是否完整、parameters 彼此是否自洽,以及不同 environments 之間是否存在合理差異。
歸因和繞過是兩回事
把原因拆到這一層,是為了知道問題出在哪裡,不是為了繞過任何防護。技術上降低被辨識的機率,不代表就取得了資料蒐集或自動化的許可。應守的邊界很明確:遵守目標網站的 robots 規則與服務條款,不蒐集個人資訊,不繞過技術保護措施,控制 request frequency,並且不影響對方服務的正常運作。這一點與技術方案無關,但優先級最高。


