
脚本本地跑得通,上线就遇到验证和 403。原因通常不是平台认出了某个工具,而是自动化访问在协议层、运行时和行为时序上留下了可观测差异。把这些差异拆开看,才知道问题出在哪一层。
一个反复出现的场景:脚本在本地跑得很好,部署到线上之后开始遇到人机验证、403、登录失败。第一反应通常是工具被认出来了。
但平台很少专门去认你用了哪个工具。它判断的是这次访问和真实用户访问之间的差异。Playwright 负责的是控制浏览器,它启动的那个环境如果和真人用的浏览器差得明显,就会被归到自动化来源那一类。差异分布在好几层,逐层看会更清楚。
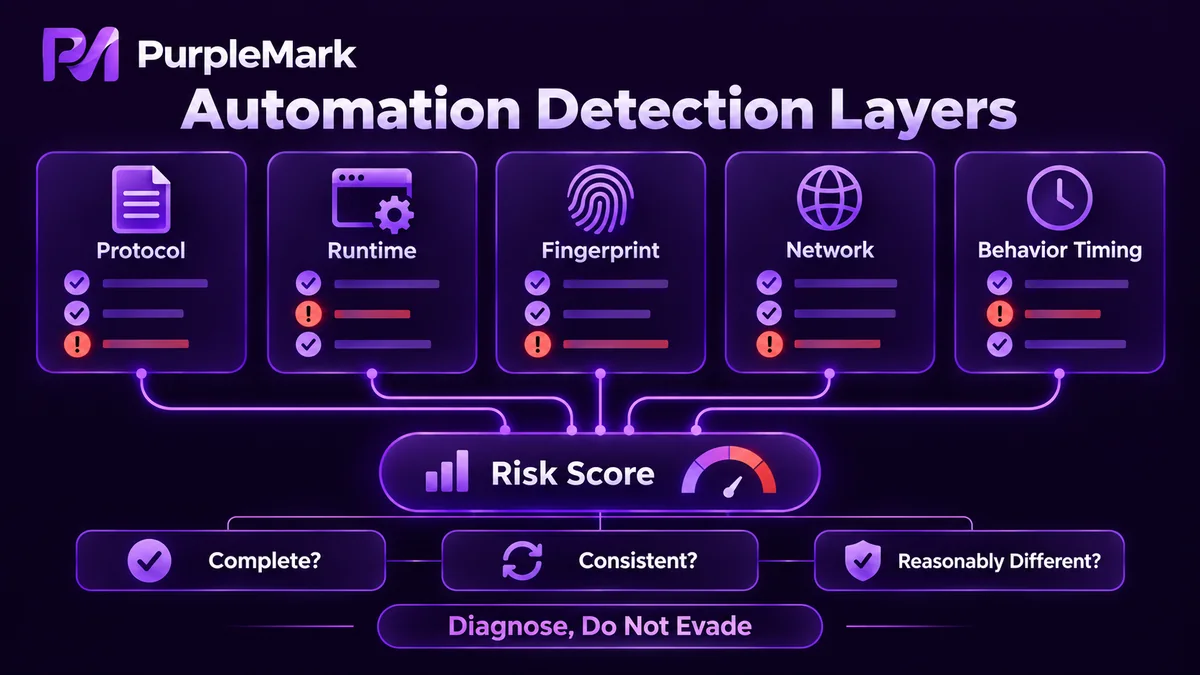
请求还没渲染,协议层已经在说话了
协议层能看到的不是页面内容,而是请求本身的形态:请求头的组合、UA Client Hints 里的浏览器版本与平台架构、连接建立过程中的参数顺序。
自动化环境在这些位置上常常显得过于干净或者过于整齐。该带的头部没带,或者每一项都固定得不像一台被人用了很久的机器。这一层的好处是判断成本很低,页面还没渲染就能得出结论,所以它被用得最普遍。
运行时变量是第二层
页面脚本跑起来之后,能读到的环境变量又是一批。WebDriver 标准规定,浏览器由自动化工具控制时,navigator.webdriver 通常返回 true。同一类信号还有启动参数里的自动化标志、window.chrome 是否存在、navigator.plugins 与 navigator.permissions 是否完整、是否以无头模式运行、插件与扩展列表是否为空。
真实浏览器一般带着若干默认项,一份空列表本身就是特征。早期的处理大多集中在这一层,因为它最容易被看到。现在很少有平台只看其中一个属性,而是把这些值连起来一起过。
指纹看的不是单项值,是彼此自洽
再往下才是设备侧参数:Canvas 与 WebGL 的渲染结果、AudioContext 的音频处理差异、字体列表、屏幕参数、时区、语言、硬件信息。这些参数单独看都不会有问题,组合起来就成了一张相对稳定的设备画像。
可疑的地方有两处。一是参数之间对不上,比如渲染结果来自一类显卡、字体集合却像另一套系统。二是一批环境之间完全一样——所有任务从同一套配置启动,指纹就会一模一样。这时候平台看到的不是一百台设备,而是同一台设备访问了一百次。
网络出口与地理信息是硬约束
网络侧的维度和浏览器没什么关系:IP 属于数据中心还是家庭宽带、这个代理地址有没有被大量滥用过、ASN 归属是云厂商还是运营商、DNS 配置与 IP 地区是否一致、IP 有没有频繁跨国家跳。
一个时区显示美国、出口落在德国的请求,不需要任何高级检测就能被挑出来。地理上的矛盾是这一整个体系里最廉价、也最容易被发现的破绽。
行为时序是慢慢累积的
真人的操作是不规律的:点击前会有短暂停顿,输入速度有快有慢,偶尔还会返回来改一下。脚本的节奏往往精确而重复,访问路径固定,从不产生目标之外的动作,请求密度也明显超过人。
这两年判法还在变。有防护厂商在 2026 年上线了持续型行为验证引擎,不再只在首次访问时判一次,而是在整个会话里持续收集鼠标移动、点击节奏、滚动轨迹和页面停留时间,实时把数据送回服务端做风险评分。刷新页面或者跳到下一个页面,已经积累的行为特征还会继续叠加,而不是从零重来。这意味着单次加载时的特征已经不够用,行为是一段过程。
平台为什么把这些当成风险信号
站在平台的立场上,它要区分的不是来访者用了什么工具,而是这次访问像不像一个真实的人在正常使用服务。它要承担的成本来自垃圾注册、批量爬取和滥用请求,所以在任何维度上出现矛盾都会让评分升高,几个维度的矛盾叠在一起就更明显。
反过来说,把特征抹掉也不是方向。真实设备的指纹是完整且自洽的,被抠掉几块的指纹在风控眼里同样是异常。更接近事实的判断标准是这三条:特征是否完整,参数之间是否自洽,不同环境之间有没有合理的差异。
归因和绕过的区别
把原因拆到这一层,是为了知道问题出在哪,不是为了绕开什么。技术上降低被识别的概率,不等于拿到了采集或自动化的许可。该守的边界很明确:遵守目标站点的 robots 协议与服务条款,不采集个人信息,不绕过技术保护措施,控制请求频率、不影响对方服务的正常运行。这条和技术方案无关,但优先级最高。


