
Un script peut fonctionner en local puis déclencher des CAPTCHA, des erreurs 403 ou des échecs de connexion après déploiement. En général, la plateforme ne reconnaît pas un outil précis : elle observe des écarts liés au protocole, au runtime, à l’empreinte, au réseau et au rythme comportemental.
Un scénario revient souvent : un script fonctionne très bien en local, puis, une fois déployé, il rencontre des vérifications humaines, des erreurs 403 ou des échecs de connexion. Le premier réflexe est généralement de penser que l’outil lui-même a été reconnu.
Pourtant, les plateformes cherchent rarement à identifier précisément l’outil utilisé. Elles évaluent plutôt l’écart entre cette visite et celle d’un véritable utilisateur. Playwright contrôle un navigateur ; si l’environnement qu’il lance diffère nettement de celui qu’une personne utilise normalement, le trafic peut être classé comme automatisé. Ces différences se répartissent sur plusieurs couches, et les examiner séparément aide à comprendre où se situe le problème.
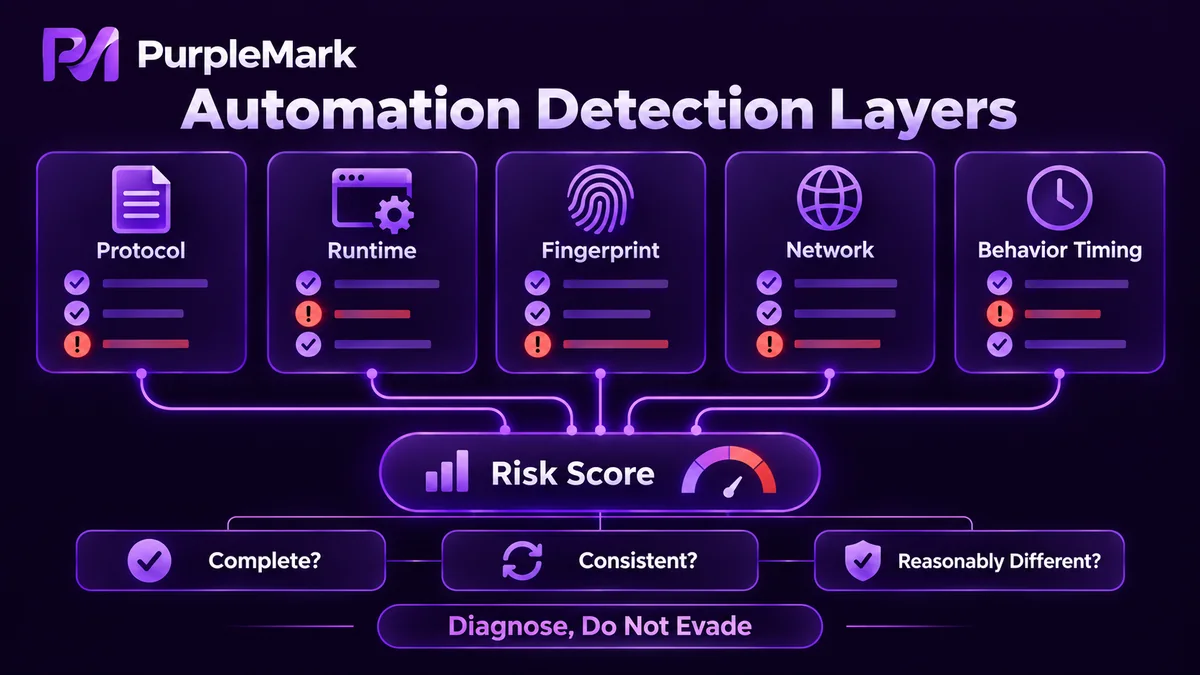
La couche protocolaire parle avant même le rendu de la page
Au niveau du protocole, ce n’est pas le contenu de la page qui est visible, mais la forme de la requête elle-même : combinaison des en-têtes, version du navigateur et architecture de plateforme dans les UA Client Hints, ainsi que l’ordre des paramètres pendant l’établissement de la connexion.
Les environnements automatisés paraissent souvent trop propres ou trop réguliers à ces endroits. Certains en-têtes attendus peuvent manquer, ou toutes les valeurs peuvent rester fixes d’une manière peu compatible avec une machine utilisée depuis longtemps par une personne. Cette couche est peu coûteuse à évaluer et permet de tirer une conclusion avant le rendu de la page, ce qui explique son usage fréquent.
Les variables de runtime forment la deuxième couche
Une fois les scripts de la page en cours d’exécution, un autre ensemble de variables d’environnement devient accessible. Selon le standard WebDriver, navigator.webdriver renvoie généralement true lorsque le navigateur est contrôlé par un outil d’automatisation. Parmi les signaux similaires figurent les indicateurs d’automatisation dans les arguments de lancement, la présence de window.chrome, l’intégrité de navigator.plugins et navigator.permissions, l’exécution en mode headless et les listes vides de plugins ou d’extensions.
Un navigateur réel contient généralement plusieurs éléments par défaut ; une liste vide peut donc devenir un signal en soi. Les premières méthodes de détection se concentraient beaucoup sur cette couche parce qu’elle était facile à observer. Aujourd’hui, rares sont les plateformes qui ne regardent qu’une propriété : elles évaluent plutôt ces valeurs ensemble.
L’empreinte vérifie la cohérence, pas une valeur isolée
Viennent ensuite les paramètres côté appareil : rendu de Canvas et WebGL, différences de traitement d’AudioContext, liste des polices, paramètres d’écran, fuseau horaire, langue et informations matérielles. Pris séparément, ils ne sont pas forcément problématiques ; ensemble, ils forment un profil d’appareil relativement stable.
Deux situations peuvent paraître suspectes. Premièrement, les paramètres peuvent être incompatibles entre eux : par exemple, le rendu ressemble à celui d’une certaine classe de GPU alors que les polices évoquent un autre système d’exploitation. Deuxièmement, tout un groupe d’environnements peut être strictement identique. Si chaque tâche démarre avec la même configuration, les empreintes seront identiques. La plateforme ne voit alors pas cent appareils, mais le même appareil cent fois.
La sortie réseau et la géographie sont des contraintes fortes
Les dimensions réseau ont peu à voir avec le navigateur lui-même : une IP appartient-elle à un centre de données ou à une connexion résidentielle, l’adresse proxy a-t-elle été massivement utilisée à mauvais escient, l’ASN dépend-il d’un fournisseur cloud ou d’un opérateur, la configuration DNS correspond-elle à la région de l’IP, et l’IP change-t-elle fréquemment de pays ?
Une requête dont le fuseau horaire indique les États-Unis alors que la sortie réseau se trouve en Allemagne peut être repérée sans aucune technique avancée. Les contradictions géographiques font partie des incohérences les moins coûteuses et les plus faciles à détecter dans tout le système.
Le rythme comportemental s’accumule progressivement
Le comportement humain est irrégulier : il y a parfois une courte pause avant un clic, la vitesse de frappe varie et l’utilisateur revient occasionnellement corriger quelque chose. Les scripts suivent souvent un rythme précis et répétitif, des parcours fixes, n’effectuent aucune action en dehors de l’objectif et produisent une densité de requêtes nettement supérieure à celle d’une personne.
Les méthodes d’évaluation ont continué d’évoluer au cours des deux dernières années. En 2026, certains fournisseurs de protection ont lancé des moteurs de vérification comportementale continue : ils ne prennent plus une seule décision lors de la première visite. Ils collectent pendant toute la session les mouvements de souris, le rythme des clics, les trajectoires de défilement et le temps passé sur la page, puis transmettent ces données au serveur en temps réel pour établir un score de risque. Actualiser la page ou passer à la suivante ne remet pas l’historique à zéro : les signaux déjà accumulés continuent de compter. Les caractéristiques d’un seul chargement ne suffisent donc plus ; le comportement est un processus.
Pourquoi les plateformes considèrent ces écarts comme des signaux de risque
Du point de vue d’une plateforme, il ne s’agit pas de savoir quel outil utilise le visiteur, mais si la visite ressemble à l’usage normal d’une personne réelle. Les inscriptions indésirables, le scraping massif et les requêtes abusives ont un coût ; toute contradiction peut donc faire monter le score de risque, et plusieurs contradictions simultanées sont encore plus visibles.
À l’inverse, effacer simplement des caractéristiques n’est pas une solution. L’empreinte d’un appareil réel est complète et cohérente ; une empreinte à laquelle certains éléments ont été volontairement retirés peut elle aussi paraître anormale. Un critère plus proche de la réalité repose sur trois questions : les caractéristiques sont-elles complètes, les paramètres sont-ils cohérents entre eux, et existe-t-il des différences raisonnables entre plusieurs environnements ?
Attribuer la cause n’est pas contourner la protection
Décomposer les causes à ce niveau sert à comprendre où se situe le problème, pas à expliquer comment contourner une protection. Réduire techniquement la probabilité d’être détecté ne donne pas l’autorisation de collecter des données ou d’automatiser un service. Les limites sont claires : respecter les règles robots et les conditions d’utilisation du site cible, ne pas collecter d’informations personnelles, ne pas contourner les mesures techniques de protection, limiter la fréquence des requêtes et ne pas perturber le fonctionnement normal du service. Cette règle est indépendante de la solution technique, mais elle reste prioritaire.


