
कोई स्क्रिप्ट स्थानीय रूप से ठीक चल सकती है, लेकिन डिप्लॉय होने के बाद CAPTCHA, 403 या लॉगिन विफलता दिखा सकती है। आम तौर पर प्लेटफ़ॉर्म किसी एक टूल को नहीं पहचानता; वह प्रोटोकॉल, रनटाइम, फिंगरप्रिंट, नेटवर्क और व्यवहारिक समय-क्रम में ऑटोमेशन से पैदा होने वाले दिखाई देने वाले अंतर देखता है।
एक स्थिति बार-बार सामने आती है: स्क्रिप्ट स्थानीय मशीन पर ठीक चलती है, लेकिन ऑनलाइन डिप्लॉय होने के बाद मानव सत्यापन, 403 या लॉगिन विफलता आने लगती है। पहली प्रतिक्रिया अक्सर यह होती है कि इस्तेमाल किया गया टूल पहचान लिया गया है।
लेकिन प्लेटफ़ॉर्म बहुत कम मामलों में यह पता लगाने पर केंद्रित होते हैं कि आपने कौन-सा टूल इस्तेमाल किया। वे इस विज़िट और किसी वास्तविक उपयोगकर्ता की विज़िट के बीच अंतर का आकलन करते हैं। Playwright ब्राउज़र को नियंत्रित करता है; यदि उसके द्वारा शुरू किया गया वातावरण किसी व्यक्ति द्वारा सामान्य रूप से इस्तेमाल किए जाने वाले ब्राउज़र से साफ़ तौर पर अलग दिखता है, तो ट्रैफ़िक को ऑटोमेटेड स्रोत माना जा सकता है। ये अंतर कई परतों में फैले होते हैं, और उन्हें अलग-अलग देखने से कारण समझना आसान होता है।
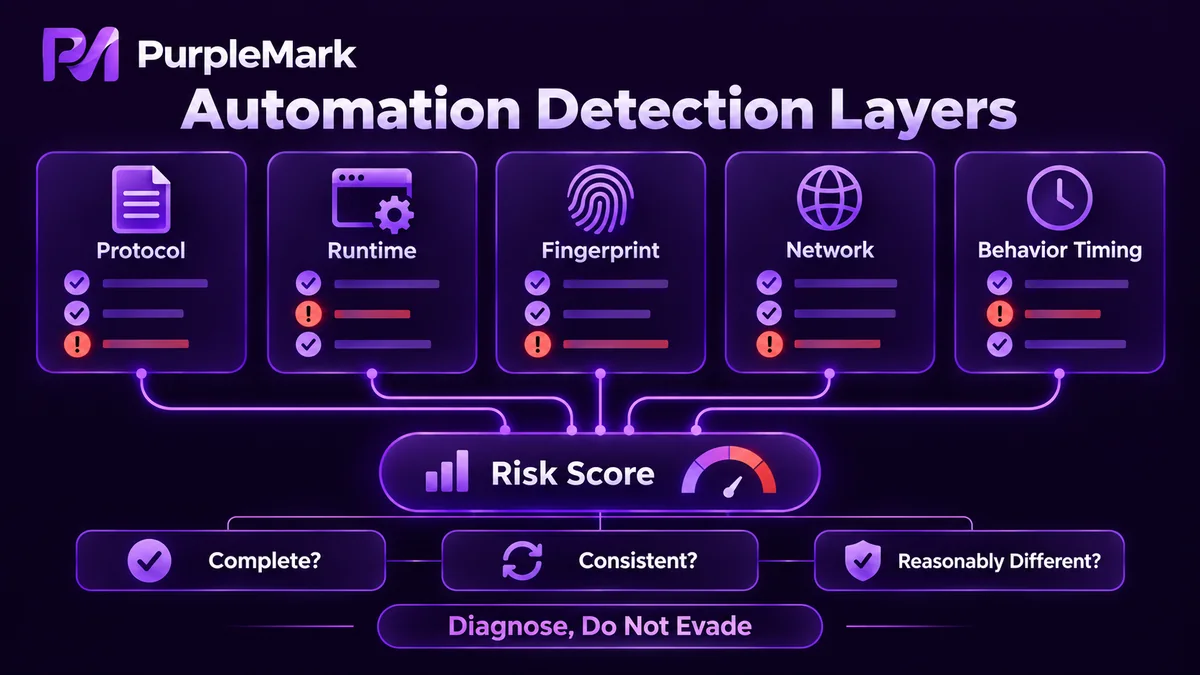
पेज रेंडर होने से पहले ही प्रोटोकॉल परत संकेत देने लगती है
प्रोटोकॉल परत पर पेज की सामग्री नहीं, बल्कि अनुरोध का स्वरूप दिखाई देता है: request headers का संयोजन, UA Client Hints में ब्राउज़र संस्करण और प्लेटफ़ॉर्म आर्किटेक्चर, तथा कनेक्शन स्थापित करते समय पैरामीटरों का क्रम।
ऑटोमेटेड वातावरण इन जगहों पर अक्सर जरूरत से ज़्यादा साफ़ या एकरूप दिखते हैं। अपेक्षित headers गायब हो सकते हैं, या हर मान इतना स्थिर हो सकता है कि वह लंबे समय से किसी व्यक्ति द्वारा इस्तेमाल की गई मशीन जैसा न लगे। इस परत का मूल्यांकन सस्ता है और पेज रेंडर होने से पहले ही निष्कर्ष निकाला जा सकता है, इसलिए इसका उपयोग बहुत व्यापक है।
रनटाइम वेरिएबल दूसरी परत हैं
पेज स्क्रिप्ट चलने के बाद वातावरण से जुड़े एक और समूह के मान पढ़े जा सकते हैं। WebDriver मानक के अनुसार, जब ब्राउज़र को ऑटोमेशन टूल नियंत्रित कर रहा हो तो navigator.webdriver आम तौर पर true लौटाता है। इसी तरह के संकेतों में launch arguments के automation flags, window.chrome की मौजूदगी, navigator.plugins और navigator.permissions की पूर्णता, headless mode का उपयोग, तथा plugins या extensions की खाली सूची शामिल हैं।
वास्तविक ब्राउज़र में आम तौर पर कुछ default items होते हैं, इसलिए खाली सूची अपने आप में एक विशेषता बन सकती है। शुरुआती detection methods इस परत पर अधिक केंद्रित थे क्योंकि इसे देखना आसान था। अब बहुत कम प्लेटफ़ॉर्म केवल एक property देखते हैं; आम तौर पर इन मानों को मिलाकर आंका जाता है।
फिंगरप्रिंट एकल मान नहीं, आपसी संगति देखता है
इसके बाद device-side parameters आते हैं: Canvas और WebGL rendering results, AudioContext processing में अंतर, fonts की सूची, screen parameters, time zone, language और hardware information। अलग-अलग देखने पर इनमें कोई समस्या न हो, फिर भी साथ मिलकर ये अपेक्षाकृत स्थिर device profile बनाते हैं।
दो तरह की चीज़ें संदिग्ध लग सकती हैं। पहली, parameters आपस में मेल न खाएँ—जैसे rendering result किसी एक प्रकार के GPU जैसा हो लेकिन fonts किसी दूसरे operating system जैसे लगें। दूसरी, कई environments पूरी तरह एक जैसे हों। यदि हर task एक ही configuration से शुरू होता है, तो fingerprints भी एक जैसे होंगे। तब प्लेटफ़ॉर्म को सौ अलग devices नहीं दिखते, बल्कि वही device सौ बार आता दिखता है।
नेटवर्क एग्रेस और भौगोलिक जानकारी कठोर सीमाएँ हैं
नेटवर्क से जुड़े आयामों का ब्राउज़र से सीधा संबंध कम है: IP data center की है या residential connection की, proxy address का बहुत अधिक दुरुपयोग हुआ है या नहीं, ASN cloud provider का है या ISP का, DNS configuration IP region से मेल खाती है या नहीं, और IP बार-बार देशों के बीच बदलती है या नहीं।
यदि किसी request का time zone United States दिखाए लेकिन उसका network egress Germany में हो, तो उसे पहचानने के लिए किसी advanced detection की जरूरत नहीं। भौगोलिक विरोधाभास पूरे सिस्टम में सबसे सस्ते और सबसे आसानी से दिखने वाले संकेतों में से हैं।
व्यवहारिक समय-क्रम धीरे-धीरे जमा होता है
मानव व्यवहार अनियमित होता है: क्लिक से पहले छोटी रुकावट हो सकती है, typing speed बदलती रहती है और लोग कभी-कभी वापस जाकर सुधार करते हैं। स्क्रिप्ट का rhythm अक्सर बहुत सटीक और दोहराव वाला होता है, navigation path तय रहता है, लक्ष्य से बाहर की गतिविधि नहीं होती और request density किसी व्यक्ति से साफ़ तौर पर अधिक हो सकती है।
पिछले दो वर्षों में आकलन के तरीके भी बदलते रहे हैं। 2026 में कुछ protection vendors ने continuous behavioral-verification engines पेश किए, जो केवल पहली विज़िट पर एक बार निर्णय नहीं लेते। वे पूरे session में mouse movement, click rhythm, scroll trajectory और page dwell time लगातार इकट्ठा करते हैं और real time में server को भेजकर risk score बनाते हैं। Page refresh करने या अगले page पर जाने से पहले से जमा behavioral signals शून्य नहीं होते; वे आगे भी जुड़ते रहते हैं। इसका अर्थ है कि एक single page load की विशेषताएँ पर्याप्त नहीं रहीं—व्यवहार एक प्रक्रिया है।
प्लेटफ़ॉर्म इन्हें risk signals क्यों मानते हैं
प्लेटफ़ॉर्म के दृष्टिकोण से सवाल यह नहीं है कि आगंतुक ने कौन-सा टूल इस्तेमाल किया, बल्कि यह है कि क्या यह access किसी वास्तविक व्यक्ति के सामान्य उपयोग जैसा दिखता है। Spam registrations, bulk scraping और abusive requests की लागत प्लेटफ़ॉर्म को उठानी पड़ती है, इसलिए किसी भी dimension में विरोधाभास risk score बढ़ा सकता है, और कई विरोधाभास एक साथ हों तो वे और स्पष्ट दिखते हैं।
दूसरी ओर, features को बस मिटा देना भी समाधान नहीं है। वास्तविक devices के fingerprints पूरे और आपस में सुसंगत होते हैं; जानबूझकर कुछ हिस्से हटाया गया fingerprint भी abnormal लग सकता है। वास्तविकता के करीब तीन सवाल हैं: क्या features पूरे हैं, क्या parameters आपस में मेल खाते हैं, और क्या अलग-अलग environments के बीच उचित अंतर है?
कारण समझना और सुरक्षा को बायपास करना अलग बातें हैं
कारणों को इस स्तर तक अलग करना यह समझने के लिए है कि समस्या किस परत में है, न कि किसी सुरक्षा को बायपास करने के लिए। Detection की संभावना तकनीकी रूप से कम करना data collection या automation की अनुमति नहीं देता। सीमाएँ स्पष्ट हैं: target site के robots rules और terms of service का पालन करें, personal information एकत्र न करें, technical protection measures को बायपास न करें, request frequency नियंत्रित रखें और सेवा के सामान्य संचालन में बाधा न डालें। यह सिद्धांत तकनीकी समाधान से अलग है, लेकिन इसकी प्राथमिकता सबसे अधिक है।


