
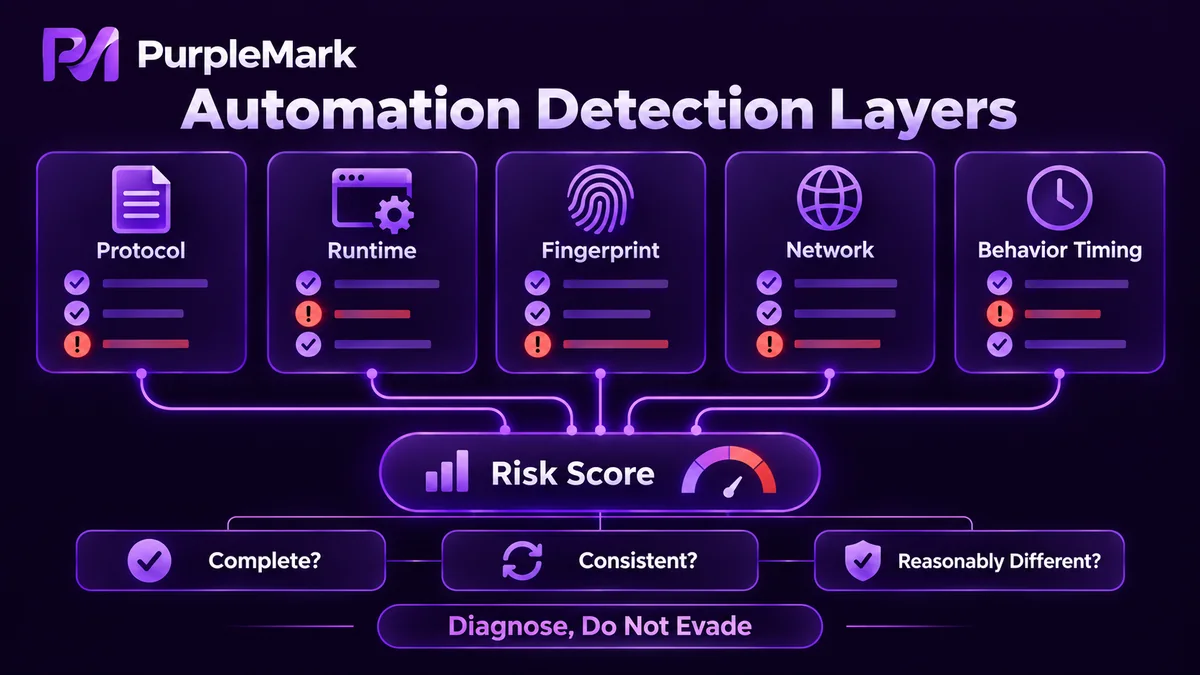
Ein Skript kann lokal problemlos laufen und nach dem Deployment dennoch CAPTCHAs, 403-Fehler oder Login-Probleme auslösen. Meist erkennt die Plattform nicht ein bestimmtes Tool, sondern beobachtbare Abweichungen automatisierter Zugriffe auf Protokoll-, Laufzeit-, Fingerprint-, Netzwerk- und Verhaltensebene.
Ein wiederkehrendes Szenario: Ein Skript läuft lokal einwandfrei, doch nach dem Deployment treten plötzlich Mensch-Prüfungen, 403-Fehler oder fehlgeschlagene Logins auf. Die erste Vermutung lautet oft, dass das verwendete Tool erkannt wurde.
Plattformen versuchen jedoch nur selten, gezielt festzustellen, welches Tool eingesetzt wird. Sie bewerten vielmehr die Unterschiede zwischen diesem Zugriff und dem Zugriff eines echten Nutzers. Playwright steuert einen Browser. Wenn sich die von Playwright gestartete Umgebung deutlich von einem Browser unterscheidet, den ein Mensch im Alltag nutzt, kann der Zugriff als automatisiert eingestuft werden. Diese Unterschiede verteilen sich auf mehrere Ebenen; getrennt betrachtet lassen sich die Ursachen besser zuordnen.
Die Protokollebene spricht, bevor die Seite gerendert wird
Auf der Protokollebene geht es nicht um den Seiteninhalt, sondern um die Form der Anfrage selbst: die Kombination der Request-Header, Browser-Version und Plattformarchitektur in den UA Client Hints sowie die Reihenfolge von Parametern beim Verbindungsaufbau.
Automatisierte Umgebungen wirken an diesen Stellen häufig zu sauber oder zu gleichförmig. Erwartete Header fehlen, oder alle Werte bleiben so starr, dass sie nicht zu einem Rechner passen, der lange von einem Menschen benutzt wurde. Diese Ebene ist kostengünstig auszuwerten und erlaubt eine Einschätzung noch vor dem Rendering der Seite. Deshalb wird sie besonders häufig genutzt.
Laufzeitvariablen bilden die zweite Ebene
Sobald Seitenskripte ausgeführt werden, wird eine weitere Gruppe von Umgebungsvariablen lesbar. Nach dem WebDriver-Standard liefert navigator.webdriver in der Regel true, wenn ein Browser von einem Automatisierungswerkzeug gesteuert wird. Ähnliche Signale sind Automatisierungsmerkmale in Startparametern, das Vorhandensein von window.chrome, die Vollständigkeit von navigator.plugins und navigator.permissions, der Headless-Betrieb sowie leere Plugin- oder Erweiterungslisten.
Echte Browser bringen normalerweise mehrere Standardeinträge mit, sodass eine leere Liste selbst zum Merkmal werden kann. Frühere Erkennungsverfahren konzentrierten sich stark auf diese Ebene, weil sie leicht sichtbar war. Heute betrachten Plattformen nur selten ein einzelnes Attribut; meist werden mehrere Werte gemeinsam ausgewertet.
Beim Fingerprinting zählt Konsistenz, nicht der Einzelwert
Darunter liegen geräteseitige Parameter: Rendering-Ergebnisse von Canvas und WebGL, Unterschiede bei der Audioverarbeitung im AudioContext, Schriftartenlisten, Bildschirmparameter, Zeitzone, Sprache und Hardwareinformationen. Einzeln sind diese Werte nicht problematisch, zusammen ergeben sie jedoch ein relativ stabiles Geräteprofil.
Zwei Dinge können auffällig sein. Erstens können die Parameter nicht zueinander passen, etwa wenn das Rendering auf eine bestimmte Grafikkartenklasse hindeutet, die Schriftarten aber eher zu einem anderen Betriebssystem gehören. Zweitens können viele Umgebungen vollständig identisch sein. Starten alle Aufgaben mit derselben Konfiguration, entstehen identische Fingerprints. Die Plattform sieht dann nicht hundert Geräte, sondern dasselbe Gerät hundertmal.
Netzwerkausgang und Geografie sind harte Randbedingungen
Netzwerkmerkmale haben wenig mit dem Browser selbst zu tun: ob eine IP zu einem Rechenzentrum oder einem privaten Anschluss gehört, ob eine Proxy-Adresse stark missbraucht wurde, ob das ASN einem Cloud-Anbieter oder Netzbetreiber zugeordnet ist, ob DNS-Konfiguration und IP-Region zusammenpassen und ob die IP häufig zwischen Ländern wechselt.
Zeigt die Zeitzone auf die USA, während der Netzwerkausgang in Deutschland liegt, lässt sich die Anfrage auch ohne fortgeschrittene Erkennung herausfiltern. Geografische Widersprüche gehören im gesamten System zu den billigsten und am leichtesten erkennbaren Auffälligkeiten.
Verhaltenstiming sammelt sich schrittweise an
Menschliche Bedienung ist unregelmäßig: Vor einem Klick gibt es kurze Pausen, die Tippgeschwindigkeit schwankt, und gelegentlich geht man zurück, um etwas zu korrigieren. Skripte folgen dagegen häufig einem präzisen, wiederholbaren Rhythmus, festen Navigationspfaden, führen keine Aktionen außerhalb des Zielablaufs aus und erzeugen deutlich mehr Anfragen als ein Mensch.
Die Bewertungsmethoden haben sich in den vergangenen zwei Jahren weiterentwickelt. 2026 führten einige Schutzanbieter kontinuierliche Systeme zur Verhaltensprüfung ein, die nicht mehr nur beim ersten Besuch einmal entscheiden. Stattdessen erfassen sie während der gesamten Sitzung fortlaufend Mausbewegungen, Klickrhythmus, Scrollpfade und Verweildauer und senden die Daten in Echtzeit zur Risikobewertung an den Server. Ein Neuladen oder der Wechsel zur nächsten Seite setzt die bereits gesammelten Verhaltensmerkmale nicht zurück; sie werden weiter angereichert. Merkmale eines einzelnen Ladevorgangs reichen daher nicht mehr aus – Verhalten ist ein Prozess.
Warum Plattformen diese Unterschiede als Risikosignale werten
Aus Sicht einer Plattform geht es nicht darum, welches Tool ein Besucher verwendet, sondern ob der Zugriff so aussieht, als würde ein echter Mensch den Dienst normal nutzen. Kosten entstehen durch Spam-Registrierungen, massenhaftes Scraping und missbräuchliche Anfragen. Widersprüche in einer Dimension können deshalb den Risikowert erhöhen; mehrere gleichzeitig sind noch deutlicher.
Umgekehrt ist es keine Lösung, Merkmale einfach zu entfernen. Echte Geräte besitzen vollständige und in sich stimmige Fingerprints; ein Fingerprint, aus dem gezielt Teile fehlen, kann ebenfalls auffallen. Realistischer sind drei Prüffragen: Sind die Merkmale vollständig? Passen die Parameter zueinander? Gibt es zwischen verschiedenen Umgebungen plausible Unterschiede?
Ursachenanalyse ist etwas anderes als Umgehung
Die Ursachen so weit aufzuschlüsseln dient dazu, die fehlerhafte Ebene zu finden, nicht dazu, Schutzmaßnahmen zu umgehen. Die Wahrscheinlichkeit einer Erkennung technisch zu senken bedeutet nicht, dass Datenerfassung oder Automatisierung erlaubt sind. Die Grenzen sind klar: robots-Regeln und Nutzungsbedingungen der Zielseite beachten, keine personenbezogenen Daten erfassen, technische Schutzmaßnahmen nicht umgehen, die Anfragefrequenz begrenzen und den normalen Betrieb des Dienstes nicht beeinträchtigen. Diese Priorität ist unabhängig von der technischen Lösung und steht an erster Stelle.


