
Un script puede funcionar bien en local y, tras desplegarlo, encontrarse con CAPTCHA, errores 403 o fallos de inicio de sesión. Normalmente la plataforma no reconoce una herramienta concreta, sino diferencias observables de la automatización en protocolo, ejecución, huella, red y secuencia de comportamiento.
Hay un escenario que se repite: un script funciona perfectamente en local, pero después de desplegarlo empieza a encontrarse con verificaciones humanas, errores 403 o fallos de inicio de sesión. La primera reacción suele ser pensar que la herramienta ha sido reconocida.
Sin embargo, las plataformas rara vez se centran en identificar qué herramienta concreta utilizas. Lo que evalúan es la diferencia entre esa visita y la de un usuario real. Playwright se encarga de controlar el navegador; si el entorno que inicia difiere claramente del navegador que usaría una persona, el tráfico puede clasificarse como automatizado. Esas diferencias aparecen en varias capas, y analizarlas por separado permite localizar mejor la causa.
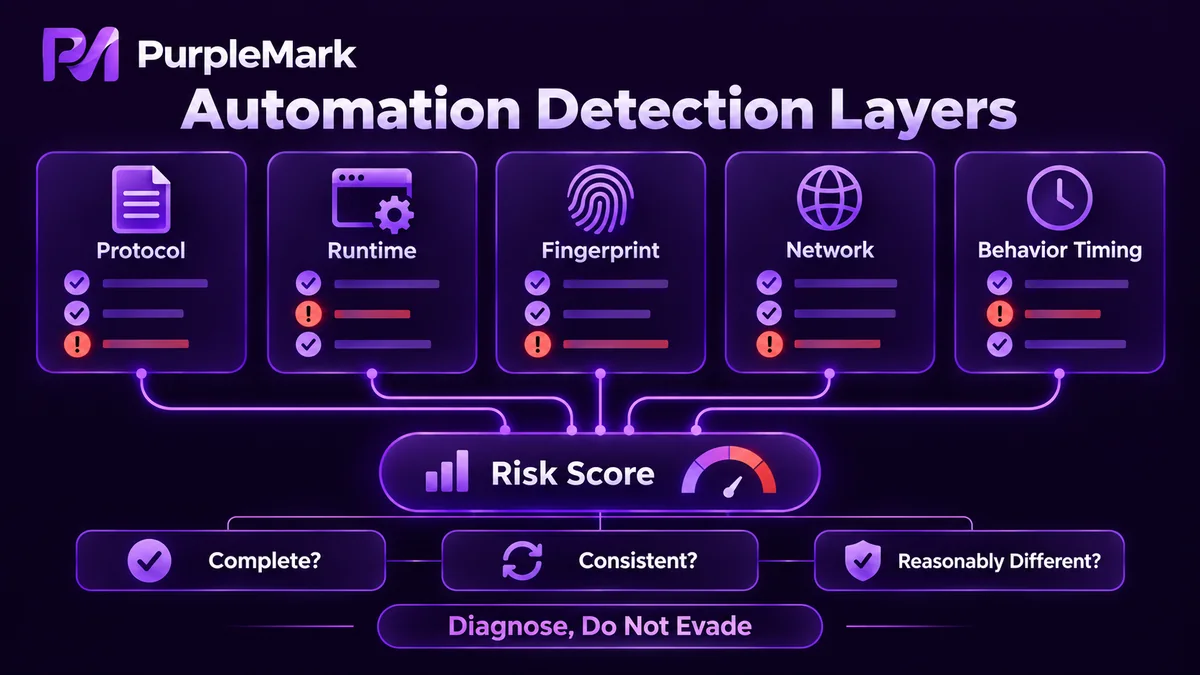
La capa de protocolo ya habla antes de renderizar la página
En la capa de protocolo no se observa el contenido de la página, sino la forma de la propia solicitud: la combinación de cabeceras, la versión del navegador y la arquitectura de plataforma expuestas por UA Client Hints, y el orden de los parámetros al establecer la conexión.
Los entornos automatizados suelen parecer demasiado limpios o demasiado uniformes en estos puntos. Pueden faltar cabeceras esperadas, o todos los valores pueden permanecer tan fijos que no se parecen a los de una máquina utilizada durante mucho tiempo por una persona. Esta capa es barata de evaluar y permite llegar a una conclusión antes de renderizar la página, por eso se usa ampliamente.
Las variables de ejecución forman la segunda capa
Cuando empiezan a ejecutarse los scripts de la página, aparece otro conjunto de variables del entorno. Según el estándar WebDriver, navigator.webdriver suele devolver true cuando el navegador está controlado por una herramienta de automatización. Señales de la misma clase son los indicadores de automatización en los argumentos de arranque, la existencia de window.chrome, la integridad de navigator.plugins y navigator.permissions, el uso de modo headless y las listas vacías de complementos o extensiones.
Los navegadores reales suelen incluir varios elementos predeterminados, por lo que una lista vacía ya puede convertirse en una característica. Los primeros métodos de detección se concentraban mucho en esta capa porque era fácil de observar. Hoy pocas plataformas miran una sola propiedad; normalmente evalúan estos valores de forma conjunta.
La huella no mira valores aislados, sino su coherencia
Después vienen los parámetros del dispositivo: resultados de renderizado de Canvas y WebGL, diferencias de procesamiento de AudioContext, listas de fuentes, parámetros de pantalla, zona horaria, idioma e información del hardware. Por separado no tienen por qué ser problemáticos, pero juntos forman un perfil del dispositivo relativamente estable.
Hay dos patrones sospechosos. El primero es que los parámetros no encajen entre sí; por ejemplo, que el renderizado parezca proceder de una clase de GPU y el conjunto de fuentes de otro sistema operativo. El segundo es que un grupo de entornos sea completamente idéntico: si todas las tareas parten de la misma configuración, sus huellas también serán iguales. La plataforma no verá cien dispositivos, sino el mismo dispositivo accediendo cien veces.
La salida de red y la geografía son restricciones fuertes
Las dimensiones de red tienen poco que ver con el navegador: si una IP pertenece a un centro de datos o a una conexión residencial, si una dirección proxy ha sufrido mucho abuso, si el ASN corresponde a un proveedor de nube o a un operador, si la configuración DNS concuerda con la región de la IP y si la IP salta con frecuencia entre países.
Una solicitud con zona horaria de Estados Unidos y salida de red en Alemania puede detectarse sin técnicas avanzadas. Las contradicciones geográficas son una de las anomalías más baratas y fáciles de identificar de todo el sistema.
La secuencia de comportamiento se acumula con el tiempo
La interacción humana es irregular: hay pequeñas pausas antes de hacer clic, la velocidad de escritura varía y a veces se vuelve atrás para corregir algo. Los scripts suelen seguir un ritmo preciso y repetitivo, rutas fijas, no realizan acciones fuera del objetivo y generan una densidad de solicitudes claramente superior a la de una persona.
Los criterios de detección han seguido cambiando durante los últimos dos años. En 2026, algunos proveedores de protección pusieron en marcha motores de verificación continua del comportamiento que ya no deciden una sola vez en la primera visita. En cambio, recopilan durante toda la sesión movimientos del ratón, ritmo de clics, trayectorias de desplazamiento y tiempo de permanencia, y envían los datos al servidor en tiempo real para calcular el riesgo. Recargar la página o pasar a la siguiente no borra las señales ya acumuladas; estas siguen sumándose. Eso significa que las características de una sola carga ya no bastan: el comportamiento es un proceso.
Por qué las plataformas tratan estas diferencias como señales de riesgo
Desde el punto de vista de una plataforma, la cuestión no es qué herramienta utiliza el visitante, sino si la visita se parece al uso normal de una persona real. La plataforma soporta costes derivados de registros basura, scraping masivo y solicitudes abusivas; por eso, una contradicción en cualquier dimensión puede elevar la puntuación de riesgo, y varias contradicciones a la vez resultan aún más visibles.
Por el contrario, borrar características tampoco es la solución. Los dispositivos reales tienen huellas completas y coherentes; una huella a la que se le han quitado partes deliberadamente también puede resultar anómala. Un criterio más ajustado a la realidad se resume en tres preguntas: ¿las características están completas?, ¿los parámetros son coherentes entre sí?, ¿existen diferencias razonables entre entornos distintos?
Atribuir la causa no es lo mismo que eludir controles
Descomponer las causas hasta este nivel sirve para saber dónde está el problema, no para explicar cómo eludir protecciones. Reducir técnicamente la probabilidad de detección no concede permiso para recopilar datos ni automatizar un servicio. Los límites son claros: respetar las reglas de robots y los términos de servicio del sitio objetivo, no recopilar información personal, no eludir medidas técnicas de protección, controlar la frecuencia de solicitudes y no afectar al funcionamiento normal del servicio. Esta regla es independiente de la solución técnica, pero tiene la máxima prioridad.


