
ローカルでは正常に動くスクリプトが、デプロイ後にCAPTCHA、403、ログイン失敗へ直面することがあります。多くの場合、特定ツールそのものが識別されるのではなく、プロトコル、ランタイム、フィンガープリント、ネットワーク、行動タイミングに残る自動化特有の差異が評価されています。
よくある状況があります。ローカルでは問題なく動いていたスクリプトが、本番環境へデプロイすると人間確認、403、ログイン失敗に遭遇し始めます。最初は「使っているツールが見抜かれた」と考えがちです。
しかし、プラットフォームが特定のツール名を直接判別しようとするケースは多くありません。見ているのは、そのアクセスと実際のユーザーによるアクセスとの差です。Playwrightはブラウザを制御しますが、起動された環境が人間が普段使うブラウザ環境と大きく異なれば、自動化由来のアクセスと分類される可能性があります。差異は複数の層に分布しており、層ごとに分けて見ると原因を理解しやすくなります。
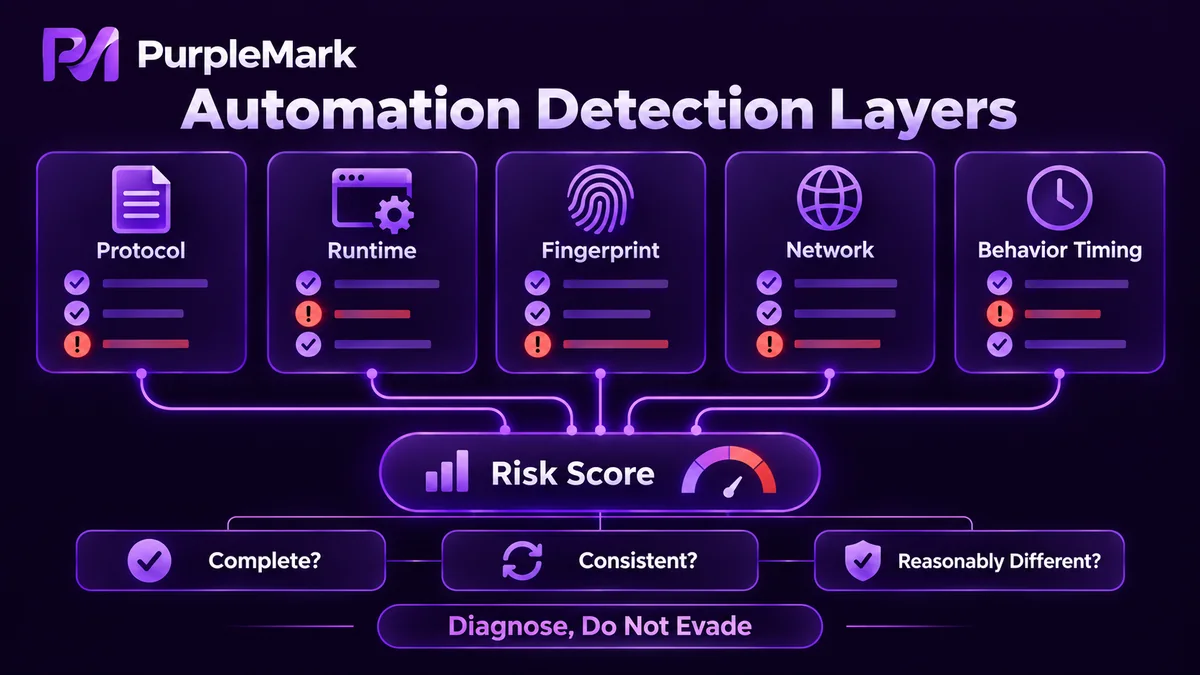
ページが描画される前からプロトコル層は情報を出している
プロトコル層で見えるのはページ内容ではなく、リクエストそのものの形です。リクエストヘッダーの組み合わせ、UA Client Hintsに含まれるブラウザバージョンやプラットフォームアーキテクチャ、接続確立時のパラメータ順序などが該当します。
自動化環境は、こうした部分が不自然にきれいだったり、整いすぎていたりします。本来あるはずのヘッダーが欠けていたり、長期間人に使われた端末とは思えないほど各値が固定されていたりします。この層は評価コストが低く、ページ描画前に判断できるため、広く使われています。
ランタイム変数が第2の層
ページスクリプトが動き始めると、別の環境変数群が読み取れるようになります。WebDriver標準では、ブラウザが自動化ツールによって制御されている場合、navigator.webdriverは通常trueを返します。同種のシグナルには、起動引数の自動化フラグ、window.chromeの有無、navigator.pluginsとnavigator.permissionsの完全性、headlessモードかどうか、プラグインや拡張機能の一覧が空かどうか、などがあります。
実際のブラウザには通常いくつかの既定項目があるため、空の一覧そのものが特徴になります。初期の検出は観測しやすいこの層に集中していました。現在では、単一の属性だけを見るプラットフォームは少なく、複数の値を組み合わせて評価するのが一般的です。
フィンガープリントは単一値ではなく整合性を見る
さらに下の層にはデバイス側のパラメータがあります。CanvasやWebGLの描画結果、AudioContextの音声処理差、フォント一覧、画面情報、タイムゾーン、言語、ハードウェア情報などです。個別の値だけなら問題がなくても、組み合わせることで比較的安定したデバイス像になります。
不自然に見えるポイントは2つあります。1つ目はパラメータ同士が一致しないことです。たとえば描画結果はある種類のGPUらしいのに、フォント構成は別のOSに見える、といったケースです。2つ目は、多数の環境が完全に同一であることです。すべてのタスクが同じ設定から起動すれば、フィンガープリントも同一になります。プラットフォームからは100台の端末ではなく、同じ1台が100回アクセスしているように見えます。
ネットワーク出口と地理情報は強い制約になる
ネットワーク側の要素はブラウザそのものとはあまり関係がありません。IPがデータセンターか家庭回線か、プロキシアドレスが大量に悪用されていないか、ASNがクラウド事業者か通信事業者か、DNS設定とIP地域が一致するか、IPが頻繁に国をまたいで変化しないか、といった点です。
タイムゾーンは米国なのにネットワーク出口はドイツ、というリクエストなら高度な検出を使わなくても目立ちます。地理的な矛盾は、この仕組み全体の中でも低コストで見つけやすい不整合の一つです。
行動タイミングは少しずつ蓄積される
人の操作は不規則です。クリック前に短い間があり、入力速度には揺れがあり、ときには戻って修正します。一方、スクリプトは正確で反復的なリズムになりやすく、移動経路も固定され、目的以外の操作をせず、人より明らかに高い密度でリクエストを送ることがあります。
ここ2年ほどで判定方法も変化しています。2026年には、一部の保護ベンダーが継続型の行動検証エンジンを導入しました。最初の訪問時に一度だけ判定するのではなく、セッション全体を通じてマウス移動、クリックのリズム、スクロール軌跡、ページ滞在時間を収集し、リアルタイムでサーバーへ送ってリスクスコアを計算します。ページを更新したり次のページへ移動したりしても、蓄積済みの行動シグナルはゼロに戻らず、そのまま積み重なります。つまり、単一のページ読み込み時の特徴だけでは不十分で、行動は一連のプロセスとして見られます。
なぜプラットフォームはこれらをリスクシグナルとみなすのか
プラットフォームの立場では、訪問者がどのツールを使ったかよりも、そのアクセスが実際の人間による通常利用に見えるかが重要です。スパム登録、大量スクレイピング、不正利用リクエストはコストにつながるため、どの層でも矛盾があればリスクスコアが上がり、複数の矛盾が重なるとさらに目立ちます。
逆に、特徴を単に消せばよいわけでもありません。実際のデバイスのフィンガープリントは完全で内部的に整合しています。一部を意図的に削ったフィンガープリントも異常に見えます。より現実に近い基準は3つです。特徴が十分にそろっているか、パラメータ同士が整合しているか、異なる環境の間に妥当な差があるか、です。
原因の特定と回避は別物
ここまで原因を分解する目的は、どの層に問題があるかを知るためであり、保護を回避するためではありません。技術的に検出されにくくすることは、データ収集や自動化の許可を得たことを意味しません。守るべき境界は明確です。対象サイトのrobotsルールと利用規約を守り、個人情報を収集せず、技術的保護措置を回避せず、リクエスト頻度を制御し、相手のサービスの正常な運用を妨げないことです。これは技術方式とは別の話ですが、最優先事項です。


