
สคริปต์อาจทำงานได้ดีในเครื่อง local แต่หลัง deploy กลับเจอ CAPTCHA, 403 หรือเข้าสู่ระบบไม่สำเร็จ โดยทั่วไปแพลตฟอร์มไม่ได้ระบุเครื่องมือใดเครื่องมือหนึ่ง แต่ประเมินความแตกต่างที่สังเกตได้ของระบบอัตโนมัติในชั้นโปรโตคอล รันไทม์ fingerprint เครือข่าย และจังหวะพฤติกรรม
มีสถานการณ์ที่เกิดซ้ำอยู่บ่อย ๆ คือสคริปต์ทำงานได้ดีในเครื่อง local แต่หลังจาก deploy แล้วเริ่มเจอการยืนยันว่าเป็นมนุษย์ ข้อผิดพลาด 403 หรือการเข้าสู่ระบบล้มเหลว ปฏิกิริยาแรกมักเป็นการคิดว่าเครื่องมือที่ใช้ถูกตรวจพบแล้ว
แต่แพลตฟอร์มแทบไม่ได้มุ่งระบุว่าใช้เครื่องมืออะไรโดยตรง สิ่งที่ประเมินคือความแตกต่างระหว่างการเข้าถึงครั้งนี้กับการใช้งานของผู้ใช้จริง Playwright มีหน้าที่ควบคุม browser หาก environment ที่มันเปิดขึ้นมาแตกต่างจาก browser ที่คนทั่วไปใช้จริงอย่างเห็นได้ชัด การเข้าถึงนั้นอาจถูกจัดเป็น automation ความแตกต่างเหล่านี้กระจายอยู่หลายชั้น และการแยกดูทีละชั้นช่วยให้เข้าใจต้นเหตุได้ชัดขึ้น
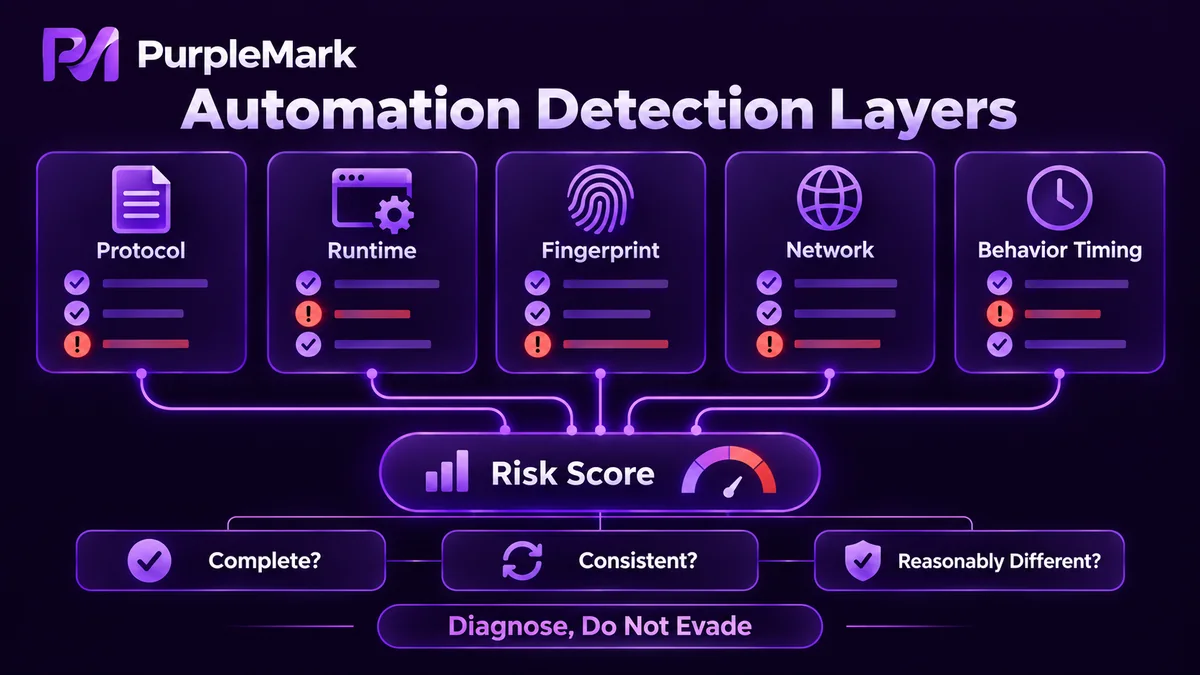
ชั้นโปรโตคอลส่งสัญญาณก่อนที่หน้าเว็บจะ render
ในชั้นโปรโตคอล สิ่งที่มองเห็นไม่ใช่เนื้อหาหน้าเว็บ แต่เป็นรูปแบบของ request เอง เช่น ชุด request headers, browser version และ platform architecture ใน UA Client Hints รวมถึงลำดับของ parameters ระหว่างการสร้าง connection
Automation environment มักดูสะอาดหรือเป็นระเบียบเกินไปในจุดเหล่านี้ Header ที่ควรมีอาจหายไป หรือค่าต่าง ๆ คงที่มากจนไม่เหมือนเครื่องที่คนใช้งานมานาน ชั้นนี้มีต้นทุนในการประเมินต่ำ และสามารถตัดสินได้ก่อนหน้าเว็บ render จึงถูกใช้อย่างแพร่หลาย
Runtime variables คือชั้นที่สอง
เมื่อ page scripts เริ่มทำงาน จะอ่านตัวแปร environment ได้อีกชุดหนึ่ง ตามมาตรฐาน WebDriver หาก browser ถูกควบคุมด้วยเครื่องมือ automation ค่า navigator.webdriver โดยทั่วไปจะเป็น true สัญญาณในกลุ่มเดียวกันยังรวมถึง automation flags ใน launch arguments, การมีอยู่ของ window.chrome, ความครบถ้วนของ navigator.plugins และ navigator.permissions, การทำงานแบบ headless และรายการ plugins หรือ extensions ที่ว่างเปล่า
Browser จริงมักมีรายการเริ่มต้นอยู่หลายอย่าง ดังนั้น empty list เองก็อาจกลายเป็นลักษณะเฉพาะได้ วิธีตรวจจับในยุคแรกจึงเน้นชั้นนี้มากเพราะสังเกตได้ง่าย ปัจจุบันมีแพลตฟอร์มน้อยมากที่ดู property เพียงค่าเดียว ส่วนใหญ่จะประเมินหลายค่าไปพร้อมกัน
Fingerprint มองความสอดคล้อง ไม่ใช่ค่าทีละตัว
ถัดลงมาคือ parameters ฝั่งอุปกรณ์ เช่น ผลการ render ของ Canvas และ WebGL, ความแตกต่างในการประมวลผลของ AudioContext, รายการ fonts, screen parameters, time zone, language และ hardware information แต่ละค่าอาจไม่ผิดปกติเมื่อดูแยกกัน แต่เมื่อนำมารวมกันจะกลายเป็น device profile ที่ค่อนข้างคงที่
มีสองรูปแบบที่อาจดูน่าสงสัย อย่างแรกคือ parameters ไม่สอดคล้องกัน เช่น ผล rendering ดูเหมือนมาจาก GPU ประเภทหนึ่ง แต่ชุด fonts กลับเหมือนอีก operating system หนึ่ง อย่างที่สองคือ environments จำนวนมากเหมือนกันทั้งหมด หากทุก task เริ่มจาก configuration เดียวกัน fingerprints ก็จะเหมือนกัน แพลตฟอร์มจะไม่ได้เห็นอุปกรณ์หนึ่งร้อยเครื่อง แต่เห็นอุปกรณ์เครื่องเดิมเข้ามาหนึ่งร้อยครั้ง
Network egress และภูมิศาสตร์เป็นข้อจำกัดที่ชัดเจน
ปัจจัยฝั่ง network แทบไม่เกี่ยวกับ browser โดยตรง เช่น IP เป็นของ data center หรือ residential connection, proxy address เคยถูกใช้ในทางที่ผิดจำนวนมากหรือไม่, ASN เป็นของ cloud provider หรือ ISP, DNS configuration ตรงกับภูมิภาคของ IP หรือไม่ และ IP เปลี่ยนประเทศบ่อยหรือไม่
Request ที่ time zone แสดงว่าอยู่ United States แต่ network egress อยู่ Germany สามารถถูกแยกออกได้โดยไม่ต้องใช้ advanced detection ความขัดแย้งทางภูมิศาสตร์เป็นหนึ่งในจุดที่ตรวจเจอได้ง่ายและมีต้นทุนต่ำที่สุดในระบบทั้งหมด
จังหวะพฤติกรรมสะสมขึ้นทีละน้อย
พฤติกรรมของคนไม่สม่ำเสมอ มีการหยุดสั้น ๆ ก่อนคลิก ความเร็วในการพิมพ์เปลี่ยนไป และบางครั้งก็ย้อนกลับมาแก้ไข Script มักมีจังหวะที่แม่นยำและซ้ำเดิม ใช้เส้นทางเข้าถึงแบบคงที่ ไม่ทำสิ่งที่อยู่นอกเป้าหมาย และมีความหนาแน่นของ request สูงกว่ามนุษย์อย่างเห็นได้ชัด
ในช่วงสองปีที่ผ่านมา วิธีประเมินยังคงเปลี่ยนแปลง ในปี 2026 ผู้ให้บริการป้องกันบางรายเปิดใช้ continuous behavioral-verification engines ซึ่งไม่ได้ตัดสินเพียงครั้งเดียวเมื่อเข้าครั้งแรก แต่เก็บ mouse movement, click rhythm, scroll trajectory และเวลาที่อยู่บนหน้าเว็บต่อเนื่องตลอด session แล้วส่งข้อมูลกลับ server แบบ real time เพื่อคำนวณ risk score การ refresh หน้าเว็บหรือไปหน้าถัดไปไม่ได้ทำให้พฤติกรรมที่สะสมไว้กลับเป็นศูนย์ แต่ยังคงถูกนำมารวมต่อไป นั่นหมายความว่าลักษณะจาก page load ครั้งเดียวไม่เพียงพออีกแล้ว พฤติกรรมคือกระบวนการต่อเนื่อง
ทำไมแพลตฟอร์มจึงมองความแตกต่างเหล่านี้เป็น risk signals
จากมุมมองของแพลตฟอร์ม สิ่งสำคัญไม่ใช่ว่าผู้เข้าชมใช้เครื่องมืออะไร แต่การเข้าถึงนั้นดูเหมือนคนจริงกำลังใช้งานบริการตามปกติหรือไม่ Spam registrations, bulk scraping และ abusive requests สร้างต้นทุนให้แพลตฟอร์ม ดังนั้นความขัดแย้งในมิติใดมิติหนึ่งอาจเพิ่ม risk score และถ้ามีหลายมิติพร้อมกันก็จะยิ่งเห็นชัด
ในทางกลับกัน การลบ features ออกเฉย ๆ ก็ไม่ใช่ทางออก Fingerprint ของอุปกรณ์จริงมีความครบถ้วนและสอดคล้องกัน หากมีการตัดบางส่วนออกโดยตั้งใจก็อาจดูผิดปกติได้เช่นกัน เกณฑ์ที่ใกล้ความจริงกว่ามีสามข้อ คือ features ครบหรือไม่, parameters สอดคล้องกันหรือไม่ และ environments ที่ต่างกันมีความแตกต่างที่สมเหตุสมผลหรือไม่
การหาสาเหตุกับการ bypass เป็นคนละเรื่อง
การแยกสาเหตุจนถึงระดับนี้มีไว้เพื่อให้รู้ว่าปัญหาอยู่ที่ชั้นไหน ไม่ใช่เพื่ออธิบายการ bypass การลดโอกาสถูกตรวจพบในเชิงเทคนิคไม่ได้แปลว่าได้รับอนุญาตให้เก็บข้อมูลหรือทำ automation ขอบเขตชัดเจน: ปฏิบัติตาม robots rules และ terms of service ของเว็บไซต์เป้าหมาย, ไม่เก็บ personal information, ไม่ bypass technical protection measures, ควบคุม request frequency และไม่กระทบการทำงานปกติของบริการ หลักการนี้ไม่ขึ้นกับแนวทางทางเทคนิค แต่มีลำดับความสำคัญสูงสุด


