
Von Selenium gestartete Browser können sich bei Debugging-Ports, für Seiten lesbaren Eigenschaften und dem Startverhalten unterscheiden. Ein Teil davon lässt sich sinnvoll konfigurieren; Versuche, die Automatisierung selbst zu verbergen, sind dagegen unnötig, fragil und oft wirkungslos.
Bei Automatisierung mit Selenium kann es passieren, dass trotz korrekter Skriptlogik kein Ergebnis zustande kommt. Viele versuchen dann zuerst, ein oder zwei Parameter zu ändern. Was die Umgebung tatsächlich auffällig macht, ist jedoch meist kein einzelner Schalter, sondern eine Kombination von Unterschieden auf mehreren Ebenen. Trennt man diese Ebenen, wird klarer, welche Maßnahmen sinnvoll sind und welche kaum etwas bringen.
Debugging-Ports und Laufzeit-Artefakte
Die Art, wie Selenium einen Browser steuert, hinterlässt zwei Arten von Spuren. Erstens kann der Browser beim Start einen Debugging-Port öffnen, über den externe Software die Seite übernehmen kann. Zweitens können in der Laufzeitumgebung zusätzliche Artefakte auftauchen, etwa vom Treiber injizierte globale Variablen mit dem Präfix cdc_, zusätzliche Treiberobjekte auf window und veränderte Bereiche bestimmter Objektprototypen.
Diese Artefakte stammen nicht von der Webseite, sondern vom Treiber selbst. Wird der Browser auf die übliche Weise gestartet, sind sie vorhanden, unabhängig davon, wie sauber das Skript geschrieben ist.
Eigenschaften, die eine Seite auslesen kann
Eine andere Art von Spur liegt nicht im Treiber, sondern in der JavaScript-Umgebung, auf die eine Seite zugreifen kann. Das bekannteste Beispiel ist navigator.webdriver.
Diese Eigenschaft kann drei Werte haben. true bedeutet, dass der Browser von einem Automatisierungswerkzeug gesteuert wird, false bedeutet, dass dies nicht der Fall ist, und undefined bedeutet, dass die entsprechende Information nicht verfügbar ist, meist weil der Browser die Eigenschaft nicht bereitstellt oder sie verändert wurde. Bei normaler menschlicher Nutzung ist sie false oder undefined; bei einem standardmäßigen Selenium-Start ist sie true.
Dazu kommt ein ganzer Satz weiterer Parameter: User-Agent, Betriebssystem und Browserversion, Bildschirmauflösung, Zeitzone, Sprache, Canvas, WebGL, AudioContext, Schriftartenliste, GPU-Modell und Anzahl der CPU-Kerne. Zusammengenommen ergeben sie den sogenannten Browser-Fingerabdruck. Bei echten Nutzern sind diese Fingerabdrücke durch unterschiedliche Systeme, Software und Gewohnheiten von Natur aus vielfältig. Browser mit Standard-Automatisierungskonfigurationen erzeugen dagegen leichter sehr ähnliche Kombinationen und lassen sich dadurch bekannten Mustern zuordnen.
Unterschiede durch Startmodus und Rendering-Timing
Die dritte Kategorie hängt nicht an einer einzelnen Eigenschaft, sondern an den Gesamteffekten der Start- und Rendering-Art.
Ein Start mit Automatisierungskennzeichen, Headless-Betrieb, nicht zueinander passende Fenster- und Bildschirmparameter, unplausible Kombinationen aus Schrift-Rendering und Grafiktreiber oder eine zu gleichmäßige Zeitverteilung vom Laden bis zur Interaktion sind für sich genommen kein Beweis. In Kombination können sie jedoch eine Umgebung ergeben, die kaum wie die eines realen Nutzers wirkt.
Headless ist ein typisches Beispiel. Der Headless-Modus neuerer Chrome-Versionen ähnelt einem normalen Browser deutlich stärker als noch vor einigen Jahren, kann im Vergleich zum regulären Modus aber weiterhin leichter Automatisierungsmerkmale zeigen, besonders auf Websites mit strengen Risikokontrollen.
Was sich sinnvoll konfigurieren lässt
Zeitzone, Sprache, Bildschirmauflösung und Schriftartenlisten sind keine Besonderheiten der Automatisierung. Reale Geräte unterscheiden sich ebenfalls. Entscheidend ist bei diesen Parametern die innere Konsistenz: Die Zeitzone sollte zur Region des Netzwerkausgangs passen, die Sprache zur üblichen Region und die Auflösung zum Hardwareprofil.
Anders gesagt: Das Ziel ist nicht, die Umgebung besonders aussehen zu lassen, sondern sie in sich stimmig zu machen. Wenn ein Gerät angeblich über Deutschland zugreift, der Browser aber eine Zeitzone der US-Westküste meldet, die Systemsprache nur Englisch ist und die Auflösung wie die eines typischen virtuellen Displays aussieht, ist diese Kombination bereits auffällig genug.
Deshalb sollten Umgebungseinstellungen möglichst dauerhaft gespeichert werden. Heute die Zeitzone zu ändern und morgen die Sprache zu vergessen, führt zu größeren Widersprüchen, als beide Werte gar nicht anzufassen.
Was die Automatisierung selbst verbergen soll und warum es sich nicht lohnt
Eine weitere Klasse von Ansätzen zielt direkt auf die Spuren: navigator.webdriver entfernen, vom Treiber injizierte Variablen löschen, Treiberobjekte verstecken oder auf andere Weise verhindern, dass die Automatisierung erkannt wird.
Das Problem ist, dass solche Maßnahmen nur die Oberfläche verändern. Erkennungssysteme prüfen längst nicht mehr nur einen einzelnen Wert; das Auslesen von Eigenschaften ist lediglich die oberste Ebene. Ein Treiber-Update, eine andere Ausführungsreihenfolge des Erkennungsskripts oder eine Prüfung, die JavaScript ganz umgeht und stattdessen Rendering-Ergebnisse sowie Kombinationen von Gerätemerkmalen betrachtet, kann frühere Anpassungen wirkungslos machen. Der Wartungsaufwand bleibt hoch, während der Nutzen weiter sinkt.
Praktisch kommt hinzu, dass solche Maßnahmen häufig genau in den Bereich fallen, den Plattformbedingungen als Umgehung technischer Schutzmaßnahmen untersagen. Auch sauber geschriebener Code ändert daran nichts, nur weil einige Eigenschaften angepasst wurden.
Die Netzwerkschicht lässt sich nicht im Skript lösen
Selbst wenn die Browserumgebung unauffällig wirkt, kann die Netzwerkschicht eine Sitzung weiterhin zuordnen. Relevant sind etwa, ob eine IP zu einem Rechenzentrum, Cloud-Server oder Proxy-Netz gehört, der historische Ruf des IP-Bereichs und dessen ASN, die Geolokalisierung, die Anfragedichte derselben IP sowie Zugriffe auf mehrere Konten oder Seiten in kurzer Zeit. Auch Cookies, Sessions und Anmeldestatus aus den Anfragen können miteinander verknüpft werden.
Das lässt sich nicht im Skript beheben, sondern nur auf der Umgebungsebene: getrennte Ausgänge für einzelne Aufgaben, Übereinstimmung zwischen Ausgangsregion und Umgebungsregion sowie kontrollierbares Anfrage-Tempo. Bei der Isolation mehrerer Aufgaben liegen Funktionen wie die von PurpleMark typischerweise auf dieser Ebene, indem jede Aufgabe eine eigene Browserumgebung und einen eigenen Netzwerkausgang erhält und die geografischen Parameter konsistent bleiben.
Sinnvolle Reihenfolge bei der Fehlersuche nach einer Sperre
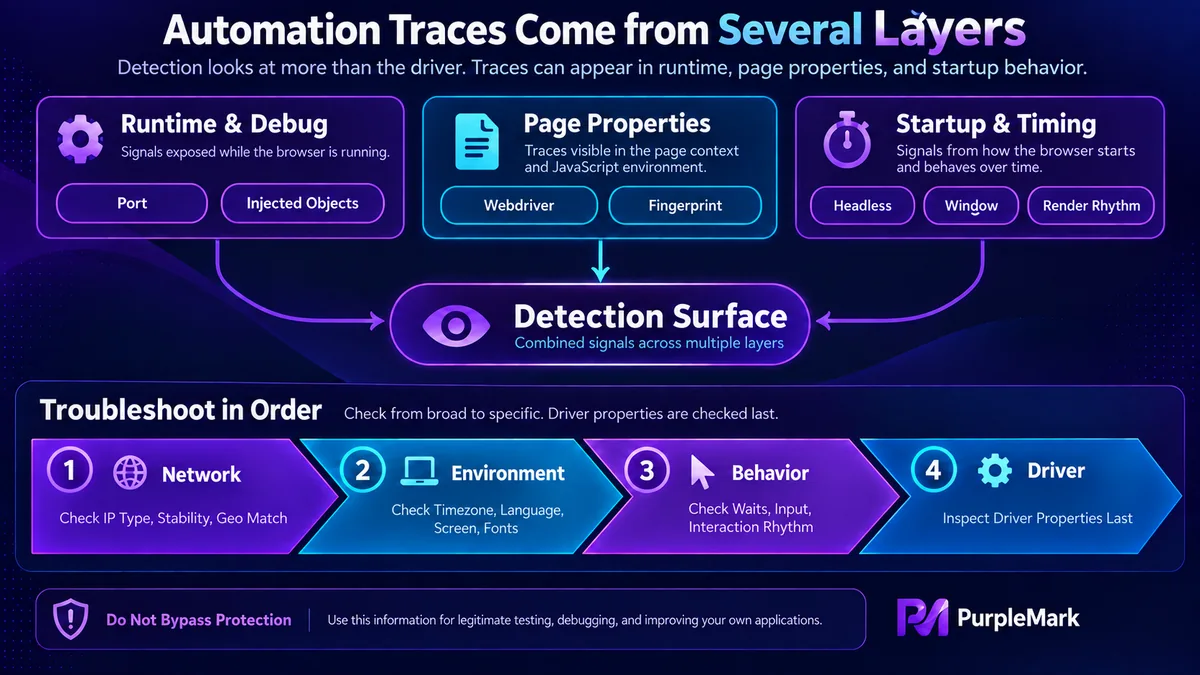
Eine sinnvolle Reihenfolge ist: zuerst die Netzwerkschicht auf IP-Typ, Stabilität und geografische Konsistenz prüfen; danach kontrollieren, ob Zeitzone, Sprache, Auflösung und Schriften in der Umgebung zusammenpassen; anschließend das Verhalten betrachten, etwa feste Wartezeiten oder sofort abgeschlossene Eingaben; und erst zuletzt die Automatisierungseigenschaften auf Treiberebene prüfen.
Der Grund ist einfach: Treiberartefakte sind längst nicht mehr der Schwerpunkt der Erkennung. Sie an die erste Stelle der Fehlersuche zu setzen, kostet meist nur Zeit.
Grenzen
Technische Maßnahmen können die Wahrscheinlichkeit einer Erkennung senken, doch einige Grenzen sollten nicht überschritten werden: die robots-Regeln und Nutzungsbedingungen der Zielseite einhalten, keine personenbezogenen Daten sammeln, keine technischen Schutzmaßnahmen umgehen, die Anfragefrequenz begrenzen und den normalen Betrieb des Dienstes nicht beeinträchtigen.


