
Les navigateurs lancés par Selenium peuvent se distinguer par leurs ports de débogage, les propriétés lisibles par les pages et leur mode de démarrage. Certains réglages sont raisonnables, tandis que chercher à masquer l’automatisation elle-même est fragile, inutile et souvent inefficace.
Avec Selenium, il peut arriver que la logique du script soit correcte sans pour autant obtenir le résultat attendu. Le premier réflexe consiste souvent à modifier un ou deux paramètres, mais ce qui rend réellement l’environnement identifiable n’est généralement pas un simple réglage isolé. Il s’agit plutôt d’un ensemble de différences à plusieurs niveaux. Les examiner séparément aide à distinguer ce qui mérite d’être configuré de ce qui a peu de chances d’apporter un résultat.
Ports de débogage et artefacts d’exécution
La manière dont Selenium contrôle le navigateur laisse deux types de traces. D’abord, le navigateur peut ouvrir au démarrage un port de débogage par lequel un logiciel externe peut prendre le contrôle de la page. Ensuite, l’environnement d’exécution peut contenir des éléments supplémentaires, par exemple des variables globales préfixées par cdc_ injectées par le pilote, des objets de pilote ajoutés à window et certaines parties modifiées de prototypes d’objets.
Ces éléments ne viennent pas de la page web, mais du pilote lui-même. Avec un démarrage standard, ils sont présents quelle que soit la qualité du script.
Propriétés lisibles par la page
Une autre catégorie de traces ne se trouve pas dans le pilote, mais dans l’environnement JavaScript accessible à la page. L’exemple le plus souvent cité est navigator.webdriver.
Cette propriété peut prendre trois valeurs. true indique que le navigateur est contrôlé par un outil d’automatisation, false qu’il ne l’est pas, et undefined que l’information n’est pas disponible, généralement parce que le navigateur n’expose pas cette propriété ou qu’elle a été modifiée. Lors d’une utilisation humaine normale, elle vaut false ou undefined, tandis qu’un lancement Selenium par défaut la place à true.
D’autres paramètres l’accompagnent : User-Agent, système d’exploitation et version du navigateur, résolution d’écran, fuseau horaire, langue, Canvas, WebGL, AudioContext, liste des polices, modèle de GPU et nombre de cœurs CPU. Ensemble, ils constituent ce que l’on appelle couramment l’empreinte du navigateur. Chez de vrais utilisateurs, les empreintes sont naturellement variées en raison des différences de systèmes, de logiciels et d’habitudes. Avec une configuration d’automatisation par défaut, les navigateurs peuvent au contraire produire des combinaisons très similaires et devenir plus faciles à rattacher à des schémas connus.
Différences liées au mode de démarrage et au timing du rendu
La troisième catégorie ne dépend d’aucune propriété isolée, mais des différences globales introduites par la manière dont le navigateur démarre et effectue son rendu.
Un lancement avec des indicateurs d’automatisation, l’exécution en mode headless, des paramètres de fenêtre et d’écran incohérents, une combinaison peu plausible entre rendu des polices et pilote graphique, ou une distribution trop régulière du temps entre chargement et interactivité ne constitue pas une preuve à lui seul. Mais, mis ensemble, ces éléments peuvent former un environnement qui ressemble peu à celui d’un utilisateur réel.
Le mode Headless en est un exemple typique. Dans les versions récentes de Chrome, il se rapproche beaucoup plus d’un navigateur normal qu’il y a quelques années, mais il peut encore révéler plus facilement des caractéristiques d’automatisation que le mode classique, en particulier sur les sites dotés de contrôles de risque stricts.
Ce qui peut être configuré de manière raisonnable
Le fuseau horaire, la langue, la résolution d’écran et la liste des polices ne sont pas propres à l’automatisation. Les appareils réels diffèrent naturellement sur ces points. L’essentiel est la cohérence interne : le fuseau horaire doit correspondre à la région de sortie réseau, la langue à la région d’usage habituelle, et la résolution ne doit pas contredire le profil matériel.
Autrement dit, le but n’est pas de rendre l’environnement exceptionnel, mais de le rendre cohérent. Si un appareil semble accéder depuis l’Allemagne alors que le navigateur annonce le fuseau de la côte ouest des États-Unis, que la langue système est uniquement l’anglais et que la résolution correspond à un affichage virtuel typique, cette combinaison est déjà suffisamment inhabituelle.
C’est aussi pourquoi les paramètres d’environnement sont mieux conservés dans un support persistant. Modifier le fuseau horaire aujourd’hui puis oublier la langue demain peut créer davantage d’incohérences que de ne rien modifier du tout.
Ce qui cherche à masquer l’automatisation elle-même, et pourquoi cela ne vaut pas la peine
Une autre classe de techniques vise directement les traces : supprimer navigator.webdriver, effacer les variables injectées par le pilote, masquer les objets du pilote ou empêcher d’une autre manière le système de détection de lire l’état d’automatisation.
Le problème est que ces techniques modifient l’apparence plutôt que le comportement sous-jacent. Les systèmes de détection ne se limitent plus depuis longtemps à une propriété unique ; la lecture des attributs n’est que la couche la plus superficielle. Une mise à jour du pilote, un changement de l’ordre d’exécution du script de détection, ou un contrôle qui contourne JavaScript pour examiner directement les résultats de rendu bas niveau et les combinaisons de caractéristiques de l’appareil peut rendre les adaptations précédentes inutiles. Le coût de maintenance reste élevé tandis que le bénéfice continue de diminuer.
Plus concrètement, ce type d’action tombe souvent précisément dans la zone que les conditions d’utilisation des plateformes décrivent comme un contournement de mesures techniques de protection. Un code propre ne change pas la nature de l’action simplement parce que quelques propriétés ont été modifiées.
La couche réseau échappe au contrôle du script
Même si l’environnement du navigateur paraît cohérent, la couche réseau peut encore identifier la session. Elle peut examiner si l’IP appartient à un centre de données, à un serveur cloud ou à un réseau proxy ; la réputation historique de la plage IP et son ASN ; la géolocalisation ; la densité des requêtes provenant de la même IP ; et le fait que cette IP accède à plusieurs comptes ou pages en peu de temps. Les Cookies, Sessions et états de connexion transmis dans les requêtes peuvent également être corrélés.
Ces problèmes ne se résolvent pas dans le script. Ils doivent être gérés au niveau de l’environnement : une sortie séparée pour chaque tâche, une cohérence entre la région de sortie et celle de l’environnement, ainsi qu’un rythme de requêtes maîtrisable. Pour isoler plusieurs tâches, des capacités comme PurpleMark interviennent généralement à ce niveau en attribuant à chaque tâche un environnement de navigateur et une sortie réseau indépendants, tout en maintenant la cohérence des paramètres géographiques.
Ordre pratique de diagnostic en cas de blocage
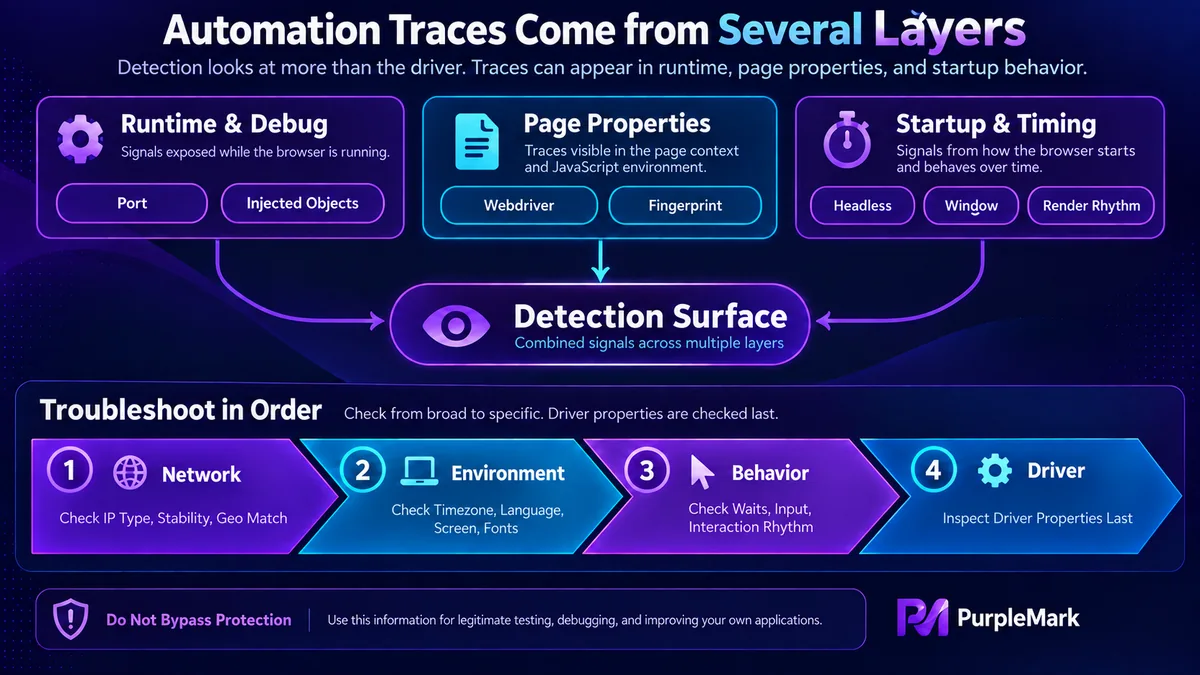
Un ordre raisonnable consiste à examiner d’abord la couche réseau pour vérifier le type d’IP, sa stabilité et sa cohérence géographique ; puis à contrôler la cohérence interne de l’environnement entre fuseau horaire, langue, résolution et polices ; ensuite à observer le rythme du comportement, par exemple des attentes toujours fixes ou une saisie instantanée ; et seulement enfin à regarder les propriétés d’automatisation au niveau du pilote.
La raison est simple : les artefacts du pilote ne sont plus le cœur de la détection. Les placer en premier dans le diagnostic fait généralement perdre du temps.
Limites
Des mesures techniques peuvent réduire la probabilité d’identification, mais certaines limites ne doivent pas être franchies : respecter les règles robots et les conditions d’utilisation du site cible, ne pas collecter d’informations personnelles, ne pas contourner les mesures techniques de protection, maîtriser la fréquence des requêtes et ne pas perturber le fonctionnement normal du service.


