
Selenium 啟動的瀏覽器會在除錯連接埠、頁面可讀屬性與啟動方式上留下差異。其中一部分屬於合理設定,另一部分試圖掩蓋自動化本身,不僅沒有必要,也很容易失效。
用 Selenium 跑自動化時,即使腳本邏輯沒有寫錯,仍可能拿不到預期結果。多數人的第一反應是去改一兩個參數,但真正讓環境露出破綻的,往往不是某個單獨開關,而是幾個不同層面上的差異。把這些層次分開來看,才更容易知道哪些事情值得做,哪些事情做了也很難有結果。
除錯連接埠與執行階段裡的痕跡
Selenium 控制瀏覽器的方式會留下兩類痕跡。第一類是瀏覽器啟動時開放的除錯連接埠,外部軟體可以透過它接管頁面;第二類是執行階段環境裡多出來的東西,例如驅動程式注入的帶有 cdc_ 前綴的全域變數、window 上額外出現的驅動物件,以及某些物件原型被修改過的部分。
這些東西的來源不是網頁,而是驅動程式本身。只要用標準方式啟動,它們就會存在,與腳本寫得好不好無關。
頁面裡讀得到的屬性
另一類痕跡相反,不在驅動程式裡,而在頁面能讀取的 JavaScript 環境中。最常被提到的是 navigator.webdriver。
這個屬性有三種取值。true 表示瀏覽器正在被自動化工具控制,false 表示沒有被控制,undefined 表示無法取得相關資訊,通常是瀏覽器沒有暴露這個屬性,或屬性經過處理。真人正常瀏覽時通常是 false 或 undefined,Selenium 預設啟動時則是 true。
在它周圍還有一整套參數:User-Agent、作業系統與瀏覽器版本、螢幕解析度、時區、語言、Canvas、WebGL、AudioContext、字型清單、GPU 型號、CPU 核心數。這些資訊組合起來,就是平常所說的瀏覽器指紋。真實使用者的裝置因為系統、軟體與使用習慣不同,指紋天然會比較分散;預設自動化設定下跑起來的瀏覽器,反而容易出現高度相似的組合,因此更容易被歸入已知模式。
啟動方式與渲染時序帶來的差異
第三類不落在任何單一屬性上,而是啟動方式與渲染方式帶來的整體差異。
帶著自動化標記啟動、在 headless 模式下執行、視窗尺寸與螢幕參數對不上、字型渲染與顯示卡驅動組合不合理、頁面從載入到可互動的時間分布過於整齊,單獨看每一項都不能算是證據,但疊在一起就可能構成一個不太像真人使用過的環境。
Headless 是最典型的例子。新版 Chrome 的 headless 模式已經比幾年前更接近真實瀏覽器,但與一般模式相比,仍然更容易露出自動化特徵,在風控嚴格的網站上尤其明顯。
哪些屬於可以合理設定的範圍
時區、語言、螢幕解析度與字型清單並不是自動化獨有的東西,真人裝置原本就各不相同。這類參數真正要滿足的是自洽:時區要與網路出口地區對得上,語言要符合常用地區,解析度則不能與硬體特徵互相衝突。
說白了,這類設定的目標不是讓環境顯得特別,而是讓它在內部說得通。如果一台看起來從德國出口存取的裝置,瀏覽器卻回報美國西岸時區,系統語言只有英文,螢幕解析度又是典型的虛擬顯示尺寸,這幾項湊在一起就已經足夠突兀。
這也是為什麼環境設定最好交給可以長期保存的載體。今天改了時區、明天忘了語言,前後對不上,反而比一次都不改更糟。
哪些是在隱藏自動化本身,為什麼不值得做
還有一類做法直接針對痕跡本身:把 navigator.webdriver 移除、清掉驅動程式注入的變數、把驅動物件藏起來,或用其他方式讓檢測端讀不到自動化狀態。
這條路的問題在於,它改的只是表象。檢測早就不只看某一個項目,讀屬性只是在最表層的一步。驅動程式一更新、檢測腳本的執行順序一變,或者對方乾脆繞過 JavaScript,直接去看底層渲染結果與裝置特徵的組合,之前的處理就可能失效。維護成本不低,收益卻還在持續下降。
更實際的是,這類操作通常正好踩在平台服務條款劃定的紅線上,也就是繞過技術保護措施。腳本寫得再整潔,行為本身的性質也不會因為改了幾個屬性而改變。
網路這一層,腳本管不了
即使瀏覽器環境挑不出明顯問題,網路層仍可能把工作階段辨識出來。這一層會看 IP 屬於資料中心、雲端伺服器還是代理網路,這段 IP 的歷史信譽與 ASN、地理位置落在哪裡、同一 IP 的請求密度有多大,以及它是否在短時間內存取多個帳號或多個頁面。請求裡攜帶的 Cookies、Sessions、登入狀態也可能被拿來做關聯。
這些問題無法在腳本裡解決,只能由環境層處理:每個任務各自使用獨立出口,出口地區與環境地區保持一致,並且可以控制請求節奏。做多任務隔離時,像 PurpleMark 這類能力通常就落在這一層,為每個任務提供獨立的瀏覽器環境與網路出口,同時保持地理參數一致。
真的被攔住時的排查順序
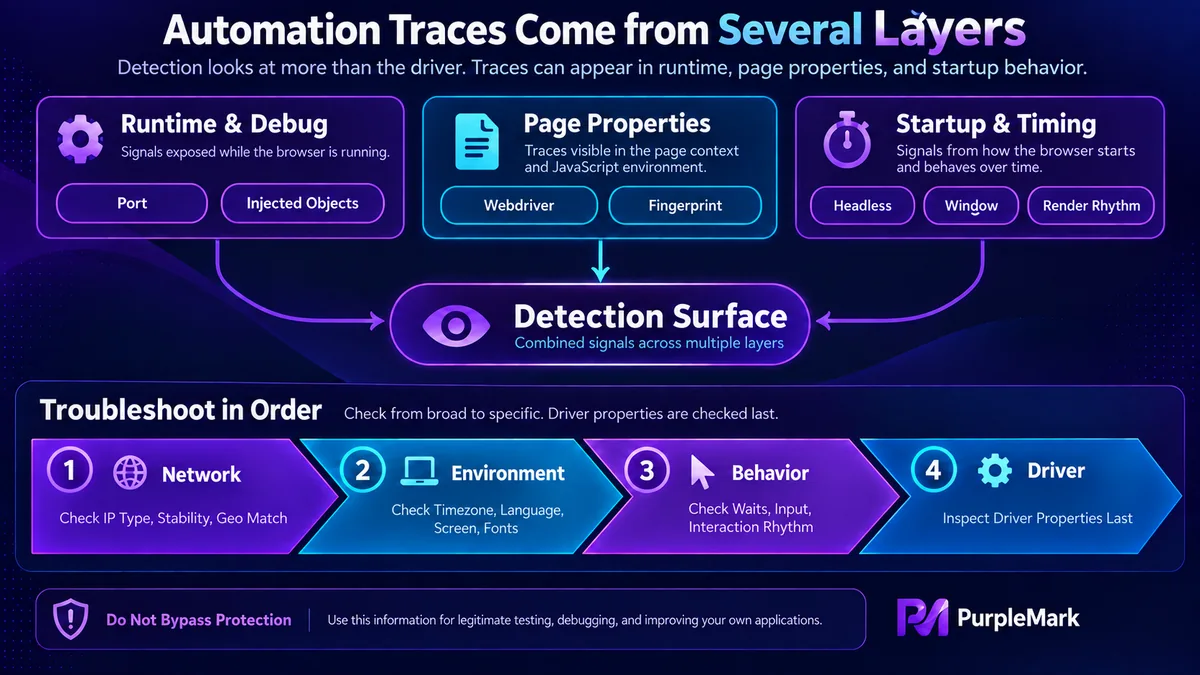
順序大致是:先看網路層,判斷 IP 類型、穩定性與地理一致性;再看環境內部是否自洽,檢查時區、語言、解析度、字型之間有沒有互相矛盾;接著看行為節奏,例如等待時間是不是固定值、輸入是不是瞬間完成;最後才輪到驅動層的自動化屬性。
原因不複雜,驅動層的那些東西早已不是檢測重點。把它放在排查的第一步,時間多半只是白花。
邊界
技術手段可以降低被辨識的機率,但有幾條線不應跨越:遵守目標網站的 robots 規則與服務條款,不蒐集個人資訊,不繞過技術保護措施,控制請求頻率,也不要影響對方服務的正常運作。


