
Agent ухвалює рішення, а Playwright керує браузером, проте рівень середовища часто лишається поза увагою. У довготривалих завданнях зі збору даних збої нерідко концентруються саме тут.
Коли Agent-фреймворк керує браузером для збору даних, архітектура зазвичай має три рівні: Agent планує та ухвалює рішення, Playwright відповідає за кліки, введення й отримання даних, а наприкінці робочий процес взаємодіє з цільовим сайтом. Короткі завдання зазвичай виконуються без проблем і проходять локальні тести. Але коли тривалість роботи зростає, а завдань стає більше, збої починають концентруватися в місці, якому рідко приділяють достатньо уваги, — у середовищі браузера.
Якщо узагальнити проблеми, що трапляються на практиці, збої рівня середовища зазвичай мають три форми.
Середовище визнається аномальним, і весь pipeline зупиняється
Один із варіантів — платформа реагує на саме середовище. Часто це виглядає не як пряме блокування, а як деградація: спрощені сторінки, порожні результати або вимога пройти перевірку. Script не повертає помилку, але отримані дані вже не мають практичної цінності. Наступні етапи продовжують працювати й переносять некоректні дані аж до фінальної таблиці.
Складність у тому, що такі середовища часто спільні для кількох завдань. Якщо одне середовище має проблему, усі пов’язані з ним завдання можуть зупинитися. Повторні спроби не допомагають, оскільки причина не в script.
Кілька завдань ділять одне середовище, і стани сесій змішуються
Коли завдання одночасно працюють в одному browser instance, Cookie, localStorage та IndexedDB можуть перезаписувати дані одне одного й витісняти стани входу. За короткий час це майже непомітно, але через кілька днів можуть з’явитися незрозумілі запити на повторну авторизацію.
Є й прихованіший drift. У браузері, що працює тривалий час, cache, storage і навіть стан рендерингу WebGL поступово змінюються. Те саме середовище сьогодні й через три дні може мати різні характеристики. Часто це сприймають як завершення строку дії Cookie, хоча насправді змінилося саме середовище. Тому зазвичай вигідніше робити середовища постійними та придатними до повторного використання об’єктами, ніж запускати новий браузер щоразу.
Під час відновлення з checkpoint початкове середовище може вже не працювати
Завдання зі збору даних рідко завершуються за один запуск. Продовження з checkpoint після переривання — звична операція, але тут легко втратити вже виконану роботу: під час restart script може створитися новий browser instance і стан входу буде втрачено; або старе середовище продовжить використовуватися, хоча платформа вже його позначила, тож подальша робота лише витрачатиме ресурси.
Ключове тут не число повторних спроб, а деталізація відновлення. Якщо поза script не зберігати, на якому етапі перебуває завдання, які дані вже отримано та яке середовище використовувалось, після перезапуску доведеться починати з нуля.
Що можна зробити на рівні середовища
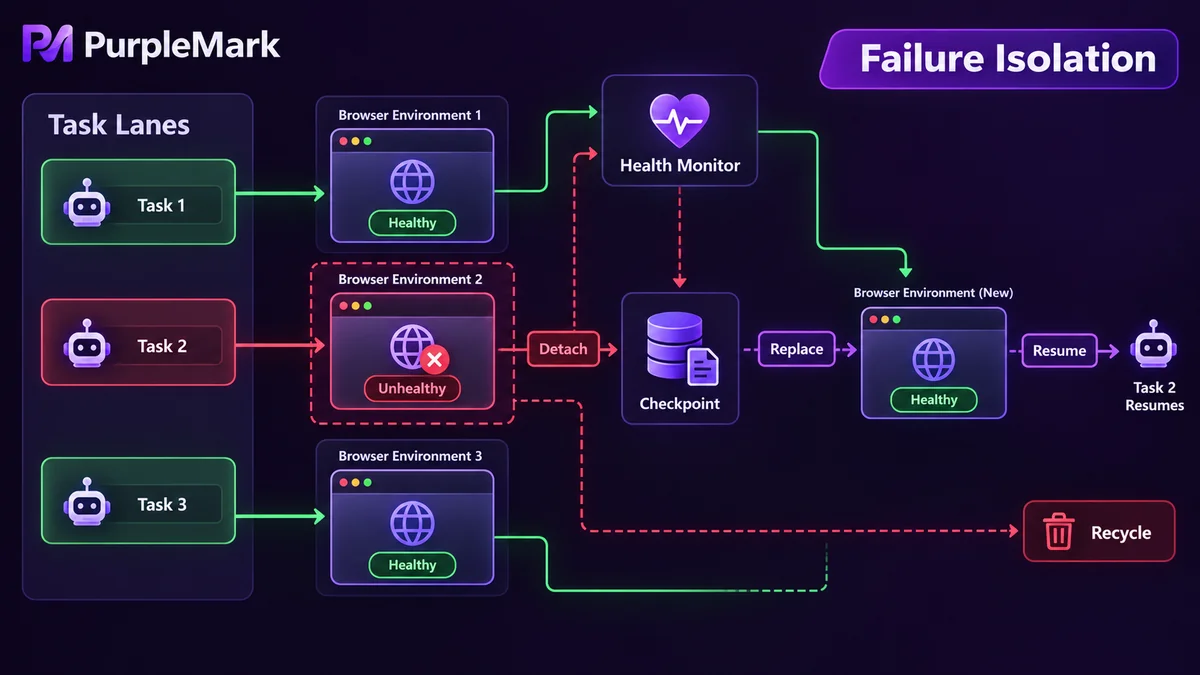
Якщо розглядати ці три проблеми разом, підхід зводиться до трьох принципів.
Групуйте середовища за завданнями. Одному завданню варто виділяти власну групу середовищ, а не розміщувати кілька завдань в одному instance. Після групування для кожного завдання можна окремо налаштувати network egress, time zone і language. Узгоджений набір таких параметрів надійніший, ніж їх ручне налаштування по одному. У такій архітектурі PurpleMark працює на рівні середовища: пакетно створює browser environment, прив’язує до кожного незалежний network egress і через API передає їх рівню оркестрації завдань для планування.
Ізолюйте збої. Якщо одне середовище визнається аномальним, це має впливати лише на завдання, пов’язані з ним. Зазвичай для кожного середовища зберігають health status, регулярно його перевіряють і при виявленні проблеми виводять середовище з роботи, замінюючи резервним. Не варто змушувати script вищого рівня знову й знову повторювати спроби в тому самому несправному середовищі. Це також спрощує діагностику: проблема в середовищі чи змінилася структура сторінки.
Зробіть стан відновлюваним. Прогрес, fingerprint для дедуплікації та ідентифікатори середовища слід постійно зберігати поза script. Після restart спочатку зчитуються ці записи, а потім визначається точка продовження та потрібне середовище. Розподіл завдання на етапи discovery, loading і extraction дає змогу окремо обробляти збої, щоб одна помилка не знецінювала весь запуск. Важливо стежити й за ресурсами: у довготривалих instance можливі витоки пам’яті, зависання сторінок і connection timeout, тому недійсні session слід регулярно оновлювати.
Межі, які потрібно чітко розділяти
Стабільність середовища й допустимість збору даних — різні питання. Спочатку потрібно перевірити robots-правила та умови використання цільового сайту, оскільки багато сайтів прямо обмежують автоматизований доступ; частоту запитів слід утримувати на рівні, що не впливає на сторонній сервіс; персональні дані не варто збирати; а за наявності технічних заходів захисту правильний підхід — змінити стратегію або отримати дозвіл, а не намагатися їх обійти. Технічна стабільність не замінює оцінку відповідності вимогам.
Матеріал призначений лише для технічних досліджень і обміну практиками розробки. Дотримуйтеся умов цільового сайту та законодавства, чинного у вашому регіоні.


