
De Agent neemt beslissingen en Playwright bedient de browser, maar de omgevingslaag wordt vaak vergeten. Bij langdurige verzameltaken concentreren storingen zich juist daar.
Wanneer een agentframework een browser aanstuurt voor dataverzameling, bestaat de architectuur meestal uit drie lagen: de Agent plant en neemt beslissingen, Playwright verzorgt klikken, invoer en gegevensextractie, en uiteindelijk communiceert de workflow met de doelsite. Korte taken draaien vaak soepel en doorstaan lokale tests. Zodra de runtime langer wordt en het aantal taken groeit, beginnen storingen zich echter te concentreren op een plek die zelden serieus genoeg wordt genomen: de browseromgeving.
Als we terugkijken op problemen uit de praktijk, zijn er grofweg drie vormen van omgevingsfouten.
De omgeving wordt als afwijkend gezien en de hele pipeline stopt
Een mogelijkheid is dat het platform zelf op de omgeving ingrijpt. Dat verschijnt vaak niet als een directe blokkade, maar als een degradatie: vereenvoudigde pagina's, lege resultaten of extra verificatie. Het script geeft geen foutmelding, maar de teruggegeven gegevens zijn niet meer bruikbaar. Downstream-stappen blijven gewoon lopen en nemen de fout mee tot in de uiteindelijke tabel.
Het lastige is dat zulke omgevingen vaak door meerdere taken worden gedeeld. Als één omgeving problemen krijgt, kunnen alle gekoppelde taken stilvallen. Opnieuw proberen helpt niet, omdat de oorzaak niet in het script zit.
Meerdere taken delen één omgeving en sessies lopen door elkaar
Wanneer taken gelijktijdig in dezelfde browserinstantie draaien, kunnen Cookie, localStorage en IndexedDB elkaar overschrijven en aanmeldstatussen verdringen. Op korte termijn merk je daar weinig van, maar na enkele dagen kunnen onverwachte verzoeken om opnieuw in te loggen verschijnen.
Er is ook een subtielere vorm van drift. In een browser die lang actief blijft, veranderen cache, opslag en zelfs de WebGL-renderingstatus geleidelijk. Dezelfde omgeving kan vandaag andere kenmerken hebben dan drie dagen later. Vaak wordt gedacht dat een Cookie is verlopen, terwijl de omgeving zelf niet meer dezelfde is. Daarom is het doorgaans efficiënter om omgevingen als persistente, herbruikbare objecten te behandelen dan iedere keer een nieuwe browser te starten.
Bij hervatten vanaf een checkpoint kan de oorspronkelijke omgeving onbruikbaar zijn
Verzameltaken zijn zelden in één run klaar. Hervatten vanaf een checkpoint na een onderbreking is normaal, maar hierbij kan werk gemakkelijk verloren gaan: bij het herstarten van het script wordt misschien een nieuwe browserinstantie aangemaakt en verdwijnt de aanmeldstatus; of de oude omgeving blijft in gebruik terwijl het platform die al heeft gemarkeerd, waardoor doorgaan alleen maar resources kost.
De kern is niet het aantal retries, maar de granulariteit van herstel. Als buiten het script niet wordt vastgelegd bij welke stap de taak is, welke gegevens al zijn verzameld en welke omgeving werd gebruikt, rest na een herstart alleen opnieuw beginnen.
Wat je aan de omgevingskant kunt doen
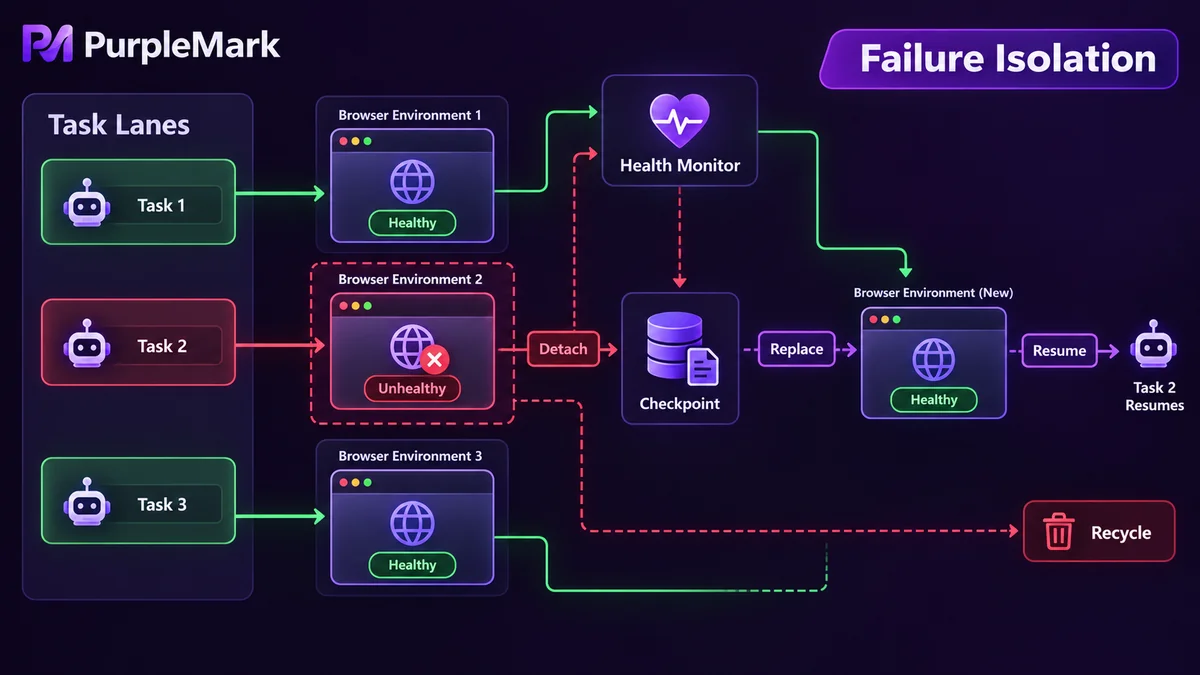
Samen leiden deze drie problemen tot drie uitgangspunten.
Groepeer omgevingen per taak. Geef elke taak een eigen groep omgevingen en stop niet meerdere taken in één instantie. Na het groeperen kan elke taak een eigen netwerkuitgang, tijdzone en taalconfiguratie krijgen. Zulke parameters als samenhangende set afstemmen is betrouwbaarder dan ze los handmatig instellen. In deze architectuur zit PurpleMark op de omgevingslaag: het maakt browseromgevingen in batches aan, koppelt iedere omgeving aan een onafhankelijke netwerkuitgang en stelt ze via een API beschikbaar aan de taakorkestratielaag voor planning.
Isoleer storingen. Als één omgeving als afwijkend wordt beoordeeld, horen alleen de eraan gekoppelde taken geraakt te worden. Gewoonlijk houdt men voor elke omgeving een gezondheidsstatus bij, controleert die periodiek en haalt een problematische omgeving uit roulatie ten gunste van een reserveomgeving, in plaats van bovenliggende scripts dezelfde defecte omgeving steeds opnieuw te laten proberen. Een bijkomend voordeel is dat de oorzaak duidelijker wordt: ligt het aan de omgeving of is de paginastructuur veranderd?
Maak status herstelbaar. Sla voortgang, deduplicatie-fingerprints en omgevingsidentificaties persistent buiten het script op. Lees die gegevens eerst bij een herstart en bepaal daarna waar de taak moet doorgaan en welke omgeving moet worden gebruikt. Splits de taak op in fasen zoals ontdekking, laden en extractie en behandel fouten per fase, zodat één storing niet de hele run ongeldig maakt. Let ook op resources: langlopende instanties kunnen geheugenlekken, vastgelopen pagina's en verbindingstime-outs krijgen, dus ongeldige sessies moeten regelmatig worden gerecycled.
Grenzen die duidelijk moeten blijven
Een stabiele omgeving en toestemming om gegevens te verzamelen zijn twee verschillende zaken. Controleer eerst de robots-regels en servicevoorwaarden van de doelsite, want veel sites beperken geautomatiseerde toegang expliciet; houd de verzoekfrequentie laag genoeg om de andere dienst niet te verstoren; verzamel geen persoonsgegevens; en pas bij technische beschermingsmaatregelen de strategie aan of vraag toestemming in plaats van te proberen ze te omzeilen. Technische stabiliteit vervangt geen nalevingsbeoordeling.
Deze inhoud is uitsluitend bedoeld voor technisch onderzoek en uitwisseling over ontwikkelpraktijken. Volg de voorwaarden van de doelsite en de wetgeving die op uw locatie van toepassing is.


