
Agent 負責決策、Playwright 負責瀏覽器操作,但環境這一層常被忽略。採集任務長期執行後,失敗往往集中出現在這裡。
用 Agent 框架驅動瀏覽器做資料採集,架構通常分成三層:Agent 負責規劃和決策,Playwright 負責點擊、輸入與取數,最後再落到目標網站。短任務通常跑得很順,本機測試也能通過。一旦把執行週期拉長、把任務鋪開,失敗就會開始集中出現在一個很少被認真處理的地方,也就是瀏覽器環境。
從實際遇過的問題往回看,環境層的問題大致有三種形態。
環境被判定異常,整條流程一起停下來
其中一種情況,是平台直接對環境本身採取處理。表現往往不是直接封鎖,而是降級:回傳簡化頁面、回傳空結果,或要求通過驗證。腳本不會拋出錯誤,但取回來的資料已經沒有意義。下游流程仍然照常執行,錯誤一路被帶到最終表格。
麻煩在於,這類環境常常由多個任務共用。一個環境出問題,掛在它上面的任務就可能全部停掉。重試也沒有用,因為問題根本不在腳本裡。
幾個任務擠在同一個環境裡,工作階段會互相干擾
並行執行任務時,如果它們共用同一個瀏覽器執行個體,Cookie、localStorage、IndexedDB 可能互相覆寫,登入狀態也會彼此頂掉。短時間內不容易看出來,但跑上幾天後,就可能遇到莫名其妙需要重新登入的情況。
還有一層更隱蔽的漂移。長時間執行的瀏覽器,快取、儲存狀態,甚至 WebGL 的渲染狀態都會逐步累積變化。同一個環境,今天執行和三天後再執行,特徵可能已經對不上。很多人以為只是 Cookie 失效,其實環境已經不是原本的環境。這也是為什麼把環境做成持久、可重複使用的物件,通常比每次重新啟動一個瀏覽器更划算。
從中斷點繼續時,原本的環境可能已經不能用了
採集任務很少一次跑完。中斷後從 checkpoint 繼續是最常見的操作,但也最容易白跑:重新啟動腳本時順手建立了一個新的瀏覽器執行個體,登入狀態就沒了;或者沿用舊環境,但它已經被平台標記,繼續跑只是在持續消耗資源。
這裡真正重要的不是重試次數,而是復原的粒度。任務跑到哪一步、已經取得哪些資料、使用的是哪個環境,如果這些資訊沒有記錄在腳本之外,重新啟動後就只能從頭開始。
環境側可以怎麼處理
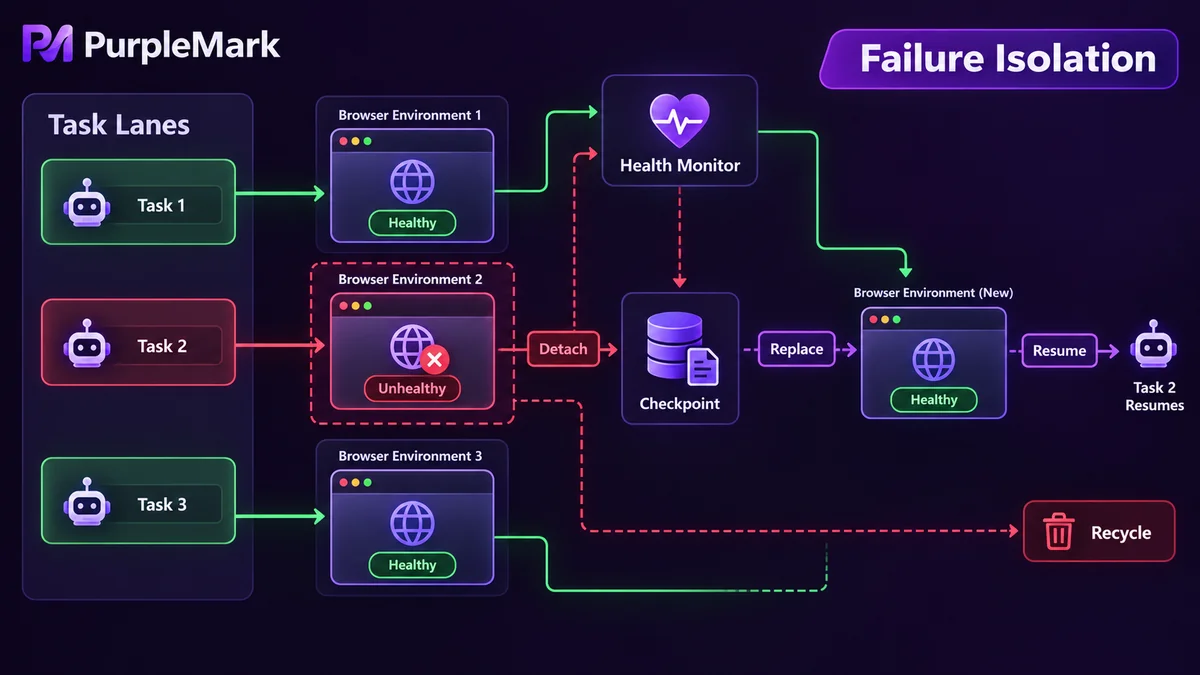
把上面三件事放在一起,思路可以整理成三點。
按任務分組環境。一個任務對應一組環境,不要把幾個任務擠在同一個執行個體裡。分組之後,可以依任務分別配置網路出口、時區和語言。這些參數成套配合,比零散地手動指定更可靠。PurpleMark 在這類架構裡的位置就是環境層:批次建立瀏覽器環境、為每個環境綁定獨立的網路出口,再透過 API 交給任務編排層排程。
隔離失敗。某個環境被判定異常時,只影響掛在它上面的任務,不要讓錯誤擴散。實作上通常會為每個環境保留一份健康狀態,定期檢查,發現異常就先摘除並換上備用環境,而不是讓上層腳本反覆重試同一個壞環境。這樣還有一個附帶好處:更容易看清楚問題到底出在環境,還是頁面結構改了。
讓狀態可復原。進度、去重指紋、環境識別碼都放在腳本之外持久保存,重新啟動時先讀取這些記錄,再決定從哪裡繼續、使用哪個環境。把任務拆成發現、載入、擷取等幾個階段分別容錯,單點失敗就不至於讓整輪白跑。資源層面也要注意,長時間執行的執行個體容易出現記憶體洩漏、頁面卡死、連線逾時等問題,無效工作階段需要定期回收。
該劃清楚的邊界
環境穩不穩,和能不能採集,是兩件不同的事。應先查看目標網站的 robots 規則與服務條款,因為不少網站會明確限制自動化存取;請求頻率要控制在不影響對方服務的程度;不要採集個人資訊;遇到技術性保護措施時,正確做法是調整策略或取得授權,而不是想辦法繞過。技術上的穩定性不能取代合規判斷。
本內容僅用於技術研究與開發實務交流,請以目標網站的條款及所在地適用法規為準。


