
Agent podejmuje decyzje, a Playwright obsługuje przeglądarkę, lecz warstwa środowiska bywa pomijana. Przy długotrwałych zadaniach zbierania danych awarie często skupiają się właśnie tam.
Gdy framework agentowy steruje przeglądarką w celu zbierania danych, architektura zwykle ma trzy warstwy: Agent planuje i podejmuje decyzje, Playwright odpowiada za klikanie, wprowadzanie danych i ich pobieranie, a na końcu przepływ pracy komunikuje się z witryną docelową. Krótkie zadania zazwyczaj działają płynnie i przechodzą testy lokalne. Kiedy jednak czas działania się wydłuża, a liczba zadań rośnie, awarie zaczynają koncentrować się w miejscu, któremu rzadko poświęca się wystarczająco dużo uwagi: w środowisku przeglądarki.
Patrząc na problemy spotykane w praktyce, awarie warstwy środowiska można z grubsza podzielić na trzy typy.
Środowisko zostaje uznane za nietypowe i zatrzymuje się cały pipeline
Pierwszy przypadek występuje wtedy, gdy platforma reaguje na samo środowisko. Często nie jest to bezpośrednia blokada, lecz degradacja: uproszczona strona, pusty wynik albo żądanie dodatkowej weryfikacji. Skrypt nie zgłasza błędu, ale zwrócone dane nie mają już wartości. Kolejne etapy nadal działają normalnie, przez co nieprawidłowe dane trafiają aż do końcowej tabeli.
Problem polega na tym, że takie środowiska są często współdzielone przez wiele zadań. Gdy jedno środowisko zaczyna sprawiać problemy, wszystkie powiązane z nim zadania mogą się zatrzymać. Ponawianie nie pomaga, ponieważ przyczyna nie leży w skrypcie.
Kilka zadań współdzieli jedno środowisko i miesza stany sesji
Jeśli zadania działają równolegle w tej samej instancji przeglądarki, Cookie, localStorage i IndexedDB mogą się wzajemnie nadpisywać i wypierać stany logowania. Przez krótki czas może to być niewidoczne, ale po kilku dniach zaczynają pojawiać się trudne do wyjaśnienia prośby o ponowne logowanie.
Istnieje też bardziej subtelny dryf. W długo działającej przeglądarce cache, pamięć i nawet stan renderowania WebGL stopniowo się zmieniają. To samo środowisko może dziś mieć inne cechy niż trzy dni później. Często zakłada się, że wygasła Cookie, podczas gdy w rzeczywistości zmieniło się samo środowisko. Dlatego traktowanie środowisk jako trwałych, wielokrotnego użytku obiektów jest zwykle korzystniejsze niż uruchamianie nowej przeglądarki za każdym razem.
Po wznowieniu z checkpointu pierwotne środowisko może już nie nadawać się do użycia
Zadania zbierania danych rzadko kończą się w jednym przebiegu. Wznowienie z checkpointu po przerwaniu jest częste, ale łatwo wtedy zmarnować wcześniejszą pracę: podczas restartu skryptu może powstać nowa instancja przeglądarki i zniknąć stan logowania; albo nadal używane jest stare środowisko, mimo że platforma już je oznaczyła, więc dalsze działanie tylko zużywa zasoby.
Kluczowa nie jest liczba ponowień, lecz szczegółowość mechanizmu odzyskiwania. Jeśli poza skryptem nie zapisuje się, na którym etapie jest zadanie, jakie dane już pobrano i którego środowiska używano, po restarcie pozostaje rozpoczęcie od początku.
Co można zrobić po stronie środowiska
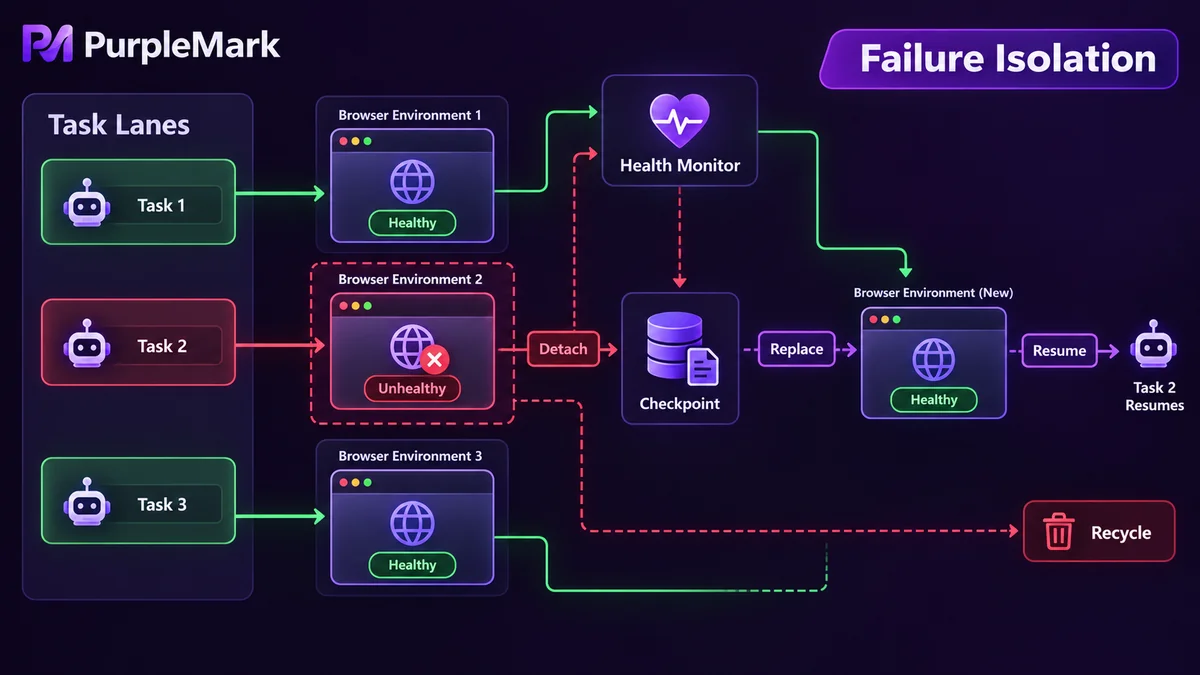
Po zestawieniu tych trzech problemów rozwiązanie sprowadza się do trzech zasad.
Grupuj środowiska według zadań. Jedno zadanie powinno otrzymać własną grupę środowisk zamiast dzielić jedną instancję z kilkoma innymi zadaniami. Po takim podziale można ustawić dla każdego zadania osobne wyjście sieciowe, strefę czasową i język. Spójne dopasowanie tych parametrów jako zestawu jest bardziej niezawodne niż ręczne ustawianie ich pojedynczo. W takiej architekturze PurpleMark działa w warstwie środowiska: tworzy środowiska przeglądarki partiami, przypisuje każdemu niezależne wyjście sieciowe i przez API przekazuje je warstwie orkiestracji zadań do planowania.
Izoluj awarie. Jeśli jedno środowisko zostanie uznane za nietypowe, powinno to wpływać wyłącznie na zadania z nim powiązane. Zwykle dla każdego środowiska przechowuje się stan zdrowia, okresowo go sprawdza i po wykryciu problemu usuwa środowisko z użycia, zastępując je zapasowym, zamiast zmuszać skrypty wyższego poziomu do ciągłego ponawiania tej samej uszkodzonej instancji. Ułatwia to również diagnozę: można rozróżnić problem środowiska od zmiany struktury strony.
Zapewnij możliwość odtworzenia stanu. Postęp, odciski do deduplikacji i identyfikatory środowisk należy trwale przechowywać poza skryptem. Po restarcie najpierw odczytuje się te dane, a następnie ustala miejsce kontynuacji i środowisko do użycia. Podział zadania na etapy, takie jak wykrywanie, ładowanie i ekstrakcja, pozwala obsługiwać błędy osobno, dzięki czemu pojedyncza awaria nie unieważnia całego przebiegu. Trzeba też pilnować zasobów: długo działające instancje mogą mieć wycieki pamięci, zawieszone strony i przekroczenia czasu połączenia, dlatego nieprawidłowe sesje należy regularnie odtwarzać.
Granice, które powinny pozostać wyraźne
Stabilność środowiska i to, czy dane wolno zbierać, to dwie różne kwestie. Najpierw należy sprawdzić reguły robots i warunki korzystania z witryny docelowej, ponieważ wiele serwisów wyraźnie ogranicza automatyczny dostęp; częstotliwość żądań powinna być na tyle niska, by nie zakłócać działania usługi; nie należy zbierać danych osobowych; a w razie napotkania technicznych środków ochrony właściwym działaniem jest zmiana strategii lub uzyskanie zgody, a nie próba ich obejścia. Stabilność techniczna nie zastępuje oceny zgodności.
Treść służy wyłącznie badaniom technicznym i wymianie doświadczeń dotyczących praktyk deweloperskich. Należy przestrzegać warunków witryny docelowej oraz przepisów obowiązujących w danej lokalizacji.


