
Agent ทำหน้าที่ตัดสินใจ ส่วน Playwright จัดการเบราว์เซอร์ แต่ชั้น environment มักถูกมองข้าม เมื่องานเก็บข้อมูลทำงานเป็นเวลานาน ปัญหามักไปรวมอยู่ที่ชั้นนี้
เมื่อใช้ Agent framework ขับเคลื่อนเบราว์เซอร์เพื่อเก็บข้อมูล สถาปัตยกรรมมักมีสามชั้น: Agent วางแผนและตัดสินใจ, Playwright รับผิดชอบการคลิก การป้อนข้อมูล และการดึงข้อมูล จากนั้น workflow จึงไปโต้ตอบกับเว็บไซต์เป้าหมาย งานสั้น ๆ มักทำงานได้ราบรื่นและผ่านการทดสอบในเครื่อง แต่เมื่อระยะเวลาทำงานยาวขึ้นและขยายจำนวนงาน ความล้มเหลวจะเริ่มไปรวมอยู่ในจุดที่มักไม่ได้รับความสนใจเพียงพอ นั่นคือ browser environment
จากปัญหาที่พบในการใช้งานจริง ปัญหาใน environment layer แบ่งได้คร่าว ๆ เป็นสามรูปแบบ
Environment ถูกมองว่าผิดปกติและ pipeline ทั้งหมดหยุดลง
กรณีหนึ่งคือแพลตฟอร์มจัดการกับ environment โดยตรง อาการมักไม่ใช่การบล็อกทันที แต่เป็นการลดระดับ เช่น ส่งหน้าที่เรียบง่ายกว่าเดิม ส่งผลลัพธ์ว่าง หรือขอให้ผ่านการยืนยันเพิ่มเติม Script ไม่ได้เกิด error แต่ข้อมูลที่ได้รับกลับมาใช้ประโยชน์ไม่ได้แล้ว ขณะที่ขั้นตอน downstream ยังทำงานต่อและพาข้อมูลผิดไปจนถึงตารางสุดท้าย
ปัญหาคือ environment ลักษณะนี้มักถูกใช้ร่วมกันหลายงาน หาก environment หนึ่งมีปัญหา งานทั้งหมดที่ผูกอยู่กับมันอาจหยุดพร้อมกัน การ retry ก็ไม่ช่วย เพราะต้นเหตุไม่ได้อยู่ใน script
หลายงานแชร์ environment เดียวกันจน session ปะปนกัน
เมื่อหลายงานทำงานพร้อมกันใน browser instance เดียว Cookie, localStorage และ IndexedDB อาจเขียนทับกันและทำให้ login state ของแต่ละงานหายไป ช่วงสั้น ๆ อาจไม่เห็นผล แต่เมื่อทำงานหลายวันจะเริ่มพบการขอให้ login ใหม่แบบไม่ทราบสาเหตุ
ยังมี drift ที่สังเกตยากกว่า ในเบราว์เซอร์ที่ทำงานเป็นเวลานาน cache, storage และแม้แต่ WebGL rendering state จะค่อย ๆ เปลี่ยนสะสม Environment เดียวกันอาจมีลักษณะวันนี้ไม่เหมือนอีกสามวันถัดไป หลายคนคิดว่า Cookie หมดอายุ แต่จริง ๆ แล้ว environment เองไม่เหมือนเดิมแล้ว นี่จึงเป็นเหตุผลว่าทำไมการทำ environment ให้เป็น object ที่ persistent และ reuse ได้จึงคุ้มกว่าการเปิดเบราว์เซอร์ใหม่ทุกครั้ง
เมื่อทำงานต่อจาก checkpoint Environment เดิมอาจใช้ไม่ได้แล้ว
งานเก็บข้อมูลแทบไม่จบภายในการรันครั้งเดียว การกลับมาทำต่อจาก checkpoint หลังการหยุดชะงักเป็นเรื่องปกติ แต่ก็เป็นจุดที่เสียงานได้ง่าย: ตอน restart script อาจสร้าง browser instance ใหม่และทำให้ login state หาย หรืออาจใช้ environment เดิมต่อทั้งที่แพลตฟอร์มได้ flag ไว้แล้ว ทำให้การรันต่อมีแต่สิ้นเปลือง resource
ประเด็นสำคัญจึงไม่ใช่จำนวนครั้งของ retry แต่เป็น granularity ของการ recovery หากไม่ได้บันทึกไว้นอก script ว่างานอยู่ขั้นตอนไหน ได้ข้อมูลอะไรมาแล้ว และกำลังใช้ environment ใด เมื่อ restart ก็ต้องเริ่มใหม่ตั้งแต่ต้น
วิธีจัดการใน environment layer
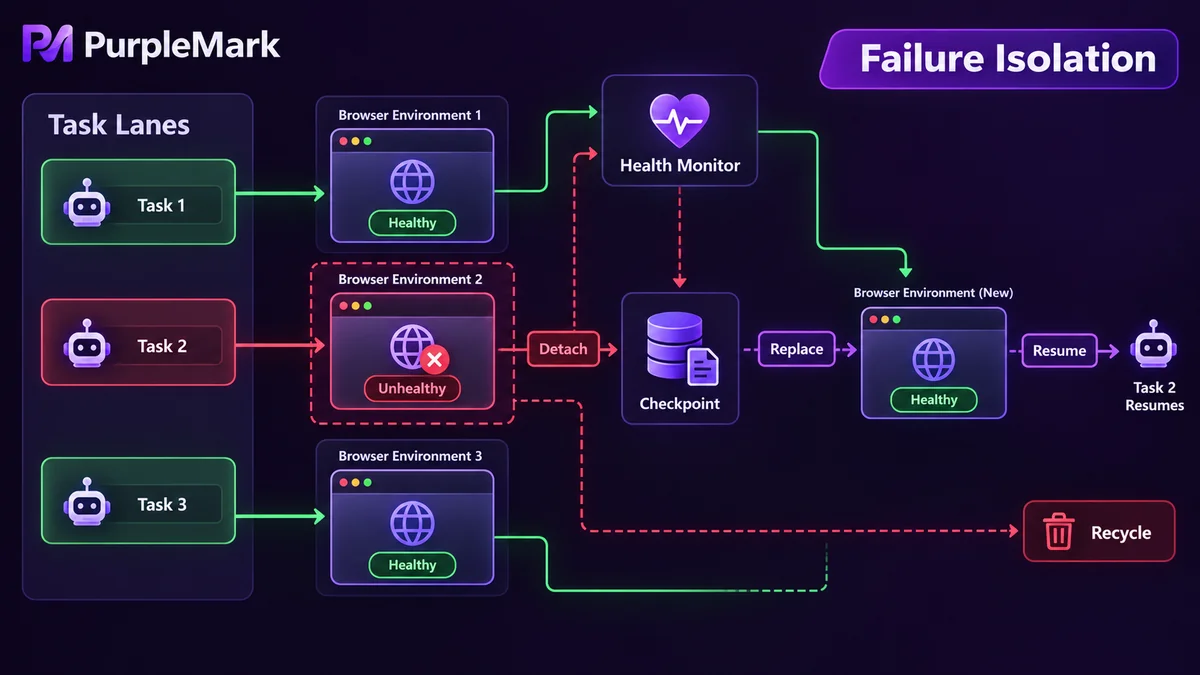
เมื่อนำทั้งสามปัญหามารวมกัน แนวคิดหลักมีสามข้อ
จัดกลุ่ม environment ตามงาน งานหนึ่งควรมีชุด environment ของตัวเอง ไม่ควรอัดหลายงานลงใน instance เดียว เมื่อแยกกลุ่มแล้วแต่ละงานสามารถตั้งค่า network egress, time zone และ language ของตัวเองได้ การทำให้พารามิเตอร์เหล่านี้สอดคล้องกันเป็นชุดมีความน่าเชื่อถือกว่าการกำหนดแยกทีละค่า ในสถาปัตยกรรมแบบนี้ PurpleMark อยู่ที่ environment layer: สร้าง browser environment เป็นชุด ผูกแต่ละ environment กับ network egress ที่เป็นอิสระ แล้วส่งผ่าน API ไปยัง task-orchestration layer เพื่อจัดตารางงาน
แยกความล้มเหลวออกจากกัน หาก environment หนึ่งถูกตัดสินว่าผิดปกติ ควรกระทบเฉพาะงานที่ผูกกับ environment นั้น วิธีทั่วไปคือเก็บ health status ของแต่ละ environment ตรวจสอบเป็นระยะ และเมื่อพบปัญหาก็นำออกแล้วเปลี่ยนเป็น standby environment แทนที่จะให้ script ชั้นบน retry environment ที่เสียเดิมซ้ำ ๆ วิธีนี้ยังช่วยให้แยกสาเหตุได้ชัดขึ้นว่าเป็นปัญหาของ environment หรือโครงสร้างหน้าเว็บเปลี่ยนไป
ทำให้ state กู้คืนได้ เก็บ progress, deduplication fingerprints และ environment identifiers ไว้นอก script แบบ persistent เมื่อ restart ให้โหลดบันทึกเหล่านี้ก่อน แล้วค่อยตัดสินใจว่าจะทำต่อจากจุดไหนและใช้ environment ใด แบ่งงานเป็นขั้นอย่าง discovery, loading และ extraction พร้อมจัดการ failure แยกกัน เพื่อให้ความล้มเหลวเพียงจุดเดียวไม่ทำให้การรันทั้งรอบสูญเปล่า ต้องดูแล resource ด้วย เพราะ instance ที่ทำงานนานอาจเกิด memory leak, หน้าเว็บค้าง หรือ connection timeout ดังนั้น session ที่ใช้ไม่ได้ควรถูก recycle เป็นระยะ
ขอบเขตที่ควรแยกให้ชัดเจน
ความเสถียรของ environment และการได้รับอนุญาตให้เก็บข้อมูลเป็นคนละเรื่อง ควรตรวจสอบ robots rules และ terms of service ของเว็บไซต์เป้าหมายก่อน เพราะหลายเว็บไซต์จำกัด automated access อย่างชัดเจน ควบคุม request rate ไม่ให้กระทบบริการของอีกฝ่าย ไม่เก็บ personal information และเมื่อพบ technical protection measures ควรปรับ strategy หรือขอ authorization แทนการพยายาม bypass ความเสถียรทางเทคนิคไม่สามารถแทนการพิจารณาด้าน compliance ได้
เนื้อหานี้มีไว้เพื่อการวิจัยทางเทคนิคและการแลกเปลี่ยนแนวปฏิบัติด้านการพัฒนาเท่านั้น โปรดปฏิบัติตามเงื่อนไขของเว็บไซต์เป้าหมายและกฎหมายที่ใช้บังคับในพื้นที่ของคุณ


