
Agent 负责决策、Playwright 负责操作,环境这一层常常没人管。采集任务长期跑下来,失败基本都集中在这里。
用 Agent 框架驱动浏览器做采集,架构通常是三层:Agent 规划和决策,Playwright 负责点击、输入、取数,最后落到目标站点。短任务跑起来很顺,本机测试也过。一旦把运行周期拉长、把任务铺开,失败就开始集中出现在一个很少被认真对待的地方,也就是浏览器环境。
从实际踩过的坑往回看,环境层的问题大致有三种形态。
环境被判异常,整条流水线一起停
一种是环境本身被平台处理了。表现往往不是直接的封禁,而是降级:返回简化页面、返回空结果、要求过验证。脚本不会抛错,但拿回来的数据已经没有意义,下游还照常跑,错误一路被带到最末端的表里。
麻烦在于这类环境常常是多个任务共用的。一个环境出问题,挂在它上面的任务全停,重试也重试不出来,因为问题根本不在脚本里。
几个任务挤在一个环境里,会话会串味
并发跑任务时,如果它们共用一个浏览器实例,Cookie、localStorage、IndexedDB 会互相覆盖,登录状态被彼此顶掉。短时间看不出来,跑上几天就会遇到那种莫名其妙的重新登录。
还有一层更隐蔽的漂移。长期运行的浏览器,缓存、存储、甚至 WebGL 的渲染状态都会慢慢累积变化。同一个环境,今天跑和三天后再跑,特征可能已经对不上了。很多人以为是 Cookie 失效,其实环境已经不是原来那个环境。这也是为什么把环境做成持久、可复用的对象,比每次重新拉一个浏览器要划算。
断点续跑时,原来的环境可能已经不能用了
采集任务很少一次跑完。中断后从断点继续是最常见的操作,也最容易白跑:重启脚本时顺手新建了一个浏览器实例,登录态没了;或者沿用了旧环境,但它已经被平台标记,继续跑等于持续消耗。
这里的关键其实不是重试次数,而是恢复的粒度。任务跑到哪一步、已经取到哪些数据、用的是哪个环境,这些如果不落在脚本之外的地方记着,重启就只能从头再来。
环境侧可以怎么处理
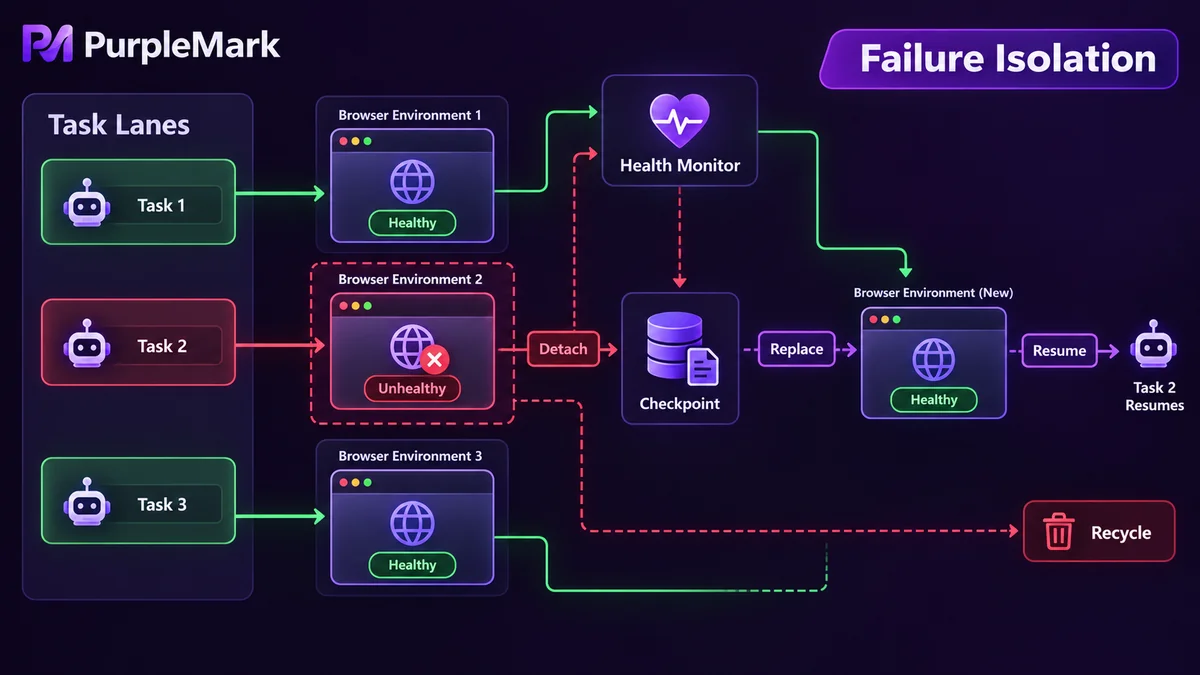
把上面三件事放在一起,思路就三条。
按任务分组环境。一个任务对一组环境,不要几个任务挤在一个实例里。分组之后,环境可以按任务各自配置网络出口、时区和语言,这些参数成套匹配,比零散地手工指定可靠得多。PurpleMark 在这类架构里的位置就是环境层:批量创建浏览器环境、给每个环境绑定独立的网络出口,再通过 API 交给任务编排层调度。
失败隔离。某个环境被判定异常时,只影响挂在它上面的任务,别让错误扩散。做法上一般会给每个环境留一份健康状态,定期检查,发现异常就摘出来换备用环境,而不是让上层脚本反复重试同一个坏环境。这样还有个附带好处:异常能被看清楚,是环境的问题,还是页面结构改了。
状态可恢复。进度、去重指纹、环境标识都放在脚本之外持久保存,重启时先读这些记录,再决定从哪继续、用哪个环境。任务拆成发现、加载、提取几个阶段分别容错,单点失败不至于让整轮白跑。资源层面也要留意,长时间运行的实例容易出现内存泄漏、页面卡死、连接超时,无效会话需要定期回收。
该划清的边界
环境稳不稳,和能不能采是两件事。目标站点的 robots 协议与服务条款要先看,不少站点明确限制自动化访问;请求频率要控制到不影响对方服务;不采集个人信息;遇到技术保护措施,正确的做法是调整策略或者去拿授权,而不是想办法绕过去。技术上的稳定替代不了合规判断。
内容仅用于技术研究与开发实践交流,请以目标站点的条款和所在地法规为准。


