
Agent निर्णय लेता है और Playwright ब्राउज़र में काम करता है, लेकिन एनवायरनमेंट लेयर अक्सर अनदेखी रह जाती है। लंबे समय तक चलने वाले कलेक्शन टास्क में विफलताएँ अक्सर यहीं केंद्रित होती हैं।
जब डेटा कलेक्शन के लिए Agent फ़्रेमवर्क ब्राउज़र चलाता है, तो आर्किटेक्चर आमतौर पर तीन लेयर का होता है: Agent योजना बनाता और निर्णय लेता है, Playwright क्लिक, इनपुट और डेटा निकालने का काम करता है, और अंत में वर्कफ़्लो टार्गेट साइट से इंटरैक्ट करता है। छोटे टास्क अक्सर आसानी से चलते हैं और लोकल टेस्ट भी पास कर लेते हैं। लेकिन जैसे ही रनटाइम लंबा होता है और टास्क बड़े पैमाने पर फैलते हैं, विफलताएँ उस हिस्से में जमा होने लगती हैं जिस पर कम ध्यान दिया जाता है: ब्राउज़र एनवायरनमेंट।
व्यावहारिक अनुभव में एनवायरनमेंट लेयर की समस्याएँ मोटे तौर पर तीन रूपों में दिखती हैं।
एनवायरनमेंट असामान्य माना जाता है और पूरी पाइपलाइन रुक जाती है
एक स्थिति में प्लेटफ़ॉर्म सीधे एनवायरनमेंट पर कार्रवाई करता है। यह हमेशा साफ़ ब्लॉक के रूप में नहीं दिखता, बल्कि degradation के रूप में दिखाई दे सकता है: सरल किया गया पेज, खाली परिणाम या verification की मांग। स्क्रिप्ट कोई error नहीं देती, लेकिन लौटाया गया डेटा अब उपयोगी नहीं रहता। इसके बाद के चरण सामान्य रूप से चलते रहते हैं और गलत डेटा अंतिम तालिका तक पहुँच जाता है।
मुश्किल यह है कि ऐसे एनवायरनमेंट अक्सर कई टास्क साझा करते हैं। एक एनवायरनमेंट में समस्या आते ही उससे जुड़े सभी टास्क रुक सकते हैं। Retry भी मदद नहीं करता, क्योंकि मूल समस्या स्क्रिप्ट में नहीं होती।
कई टास्क एक ही एनवायरनमेंट में चलते हैं और session state आपस में मिलती है
अगर कई टास्क एक ही browser instance में साथ-साथ चलते हैं, तो Cookie, localStorage और IndexedDB एक-दूसरे के डेटा को overwrite कर सकते हैं और login state बदल सकती है। कम समय में यह दिखाई नहीं देता, लेकिन कुछ दिनों बाद बिना स्पष्ट कारण के फिर से login माँगा जा सकता है।
एक और अधिक छिपा हुआ drift भी होता है। लंबे समय तक चलने वाले browser में cache, storage और यहाँ तक कि WebGL rendering state भी धीरे-धीरे बदलते रहते हैं। वही एनवायरनमेंट आज और तीन दिन बाद अलग characteristics दिखा सकता है। कई लोग इसे Cookie expire होना समझते हैं, जबकि असल में एनवायरनमेंट ही बदल चुका होता है। इसी वजह से एनवायरनमेंट को persistent और reusable object बनाना हर बार नया browser शुरू करने से अधिक उपयोगी है।
Checkpoint से दोबारा शुरू करने पर पुराना एनवायरनमेंट काम का नहीं रह सकता
डेटा कलेक्शन के टास्क कम ही एक रन में पूरे होते हैं। रुकावट के बाद checkpoint से जारी रखना सामान्य है, लेकिन यहीं काम आसानी से बेकार भी हो सकता है: स्क्रिप्ट restart करते समय नया browser instance बन जाता है और login state चली जाती है; या पुराना एनवायरनमेंट जारी रखा जाता है जबकि प्लेटफ़ॉर्म उसे पहले ही flag कर चुका होता है, जिससे आगे चलाना केवल resources खर्च करता है।
यहाँ असली मुद्दा retry की संख्या नहीं, recovery की granularity है। टास्क किस चरण पर है, कौन-सा डेटा पहले ही मिल चुका है और कौन-सा एनवायरनमेंट इस्तेमाल हो रहा था—अगर यह सब स्क्रिप्ट के बाहर दर्ज नहीं है, तो restart पर शुरुआत से शुरू करना पड़ता है।
एनवायरनमेंट लेयर पर क्या किया जा सकता है
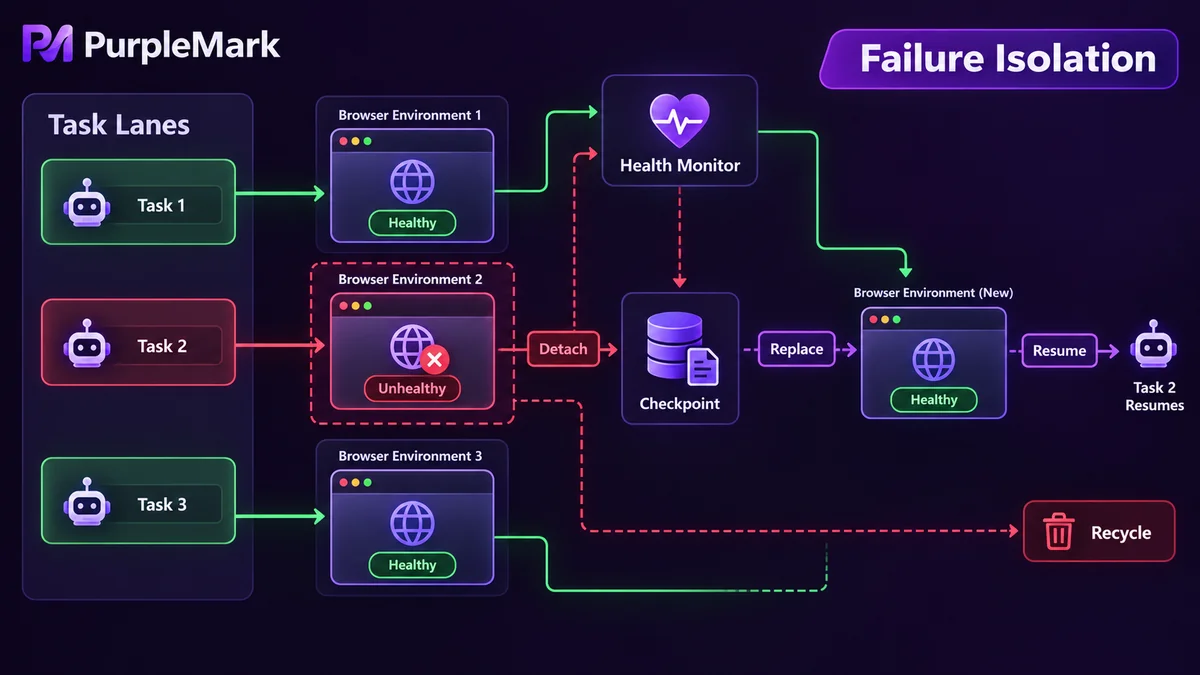
इन तीनों समस्याओं को साथ देखें तो समाधान तीन मुख्य विचारों में सिमटता है।
टास्क के अनुसार एनवायरनमेंट group करें। हर टास्क को एनवायरनमेंट का अपना group दें और कई टास्क को एक instance में न ठूँसें। Grouping के बाद हर टास्क के लिए अलग network egress, time zone और language configuration रखी जा सकती है। इन parameters को एक मेल खाते set के रूप में रखना, उन्हें अलग-अलग हाथ से सेट करने से अधिक भरोसेमंद है। इस आर्किटेक्चर में PurpleMark एनवायरनमेंट लेयर पर रहता है: यह browser environments को batch में बनाता है, हर environment को अलग network egress से जोड़ता है और API के जरिए task-orchestration layer को schedule करने के लिए देता है।
Failure isolate करें। अगर कोई environment असामान्य माना जाए, तो केवल उसी से जुड़े task प्रभावित हों। आम तौर पर हर environment का health status रखा जाता है, नियमित जाँच होती है और समस्या मिलने पर उसे हटाकर standby environment लगाया जाता है, बजाय इसके कि ऊपर की scripts उसी खराब environment को बार-बार retry करें। इससे diagnosis भी आसान होता है: समस्या environment में है या page structure बदल गया है।
State को recoverable बनाएँ। Progress, deduplication fingerprints और environment identifiers को script के बाहर persistent रूप से save करें। Restart पर पहले ये records पढ़ें, फिर तय करें कि कहाँ से जारी रखना है और कौन-सा environment इस्तेमाल करना है। Task को discovery, loading और extraction जैसे stages में बाँटकर हर stage पर अलग failure handling रखें, ताकि एक failure पूरी run को बेकार न करे। Resources पर भी ध्यान दें: लंबे समय तक चलने वाले instances में memory leak, page freeze और connection timeout हो सकते हैं, इसलिए invalid sessions को नियमित रूप से recycle करना चाहिए।
सीमाएँ स्पष्ट रहनी चाहिए
एनवायरनमेंट स्थिर होना और डेटा एकत्र करने की अनुमति होना अलग-अलग बातें हैं। पहले target site के robots rules और terms of service देखें, क्योंकि कई sites automated access को स्पष्ट रूप से सीमित करती हैं; request rate इतना रखें कि दूसरी सेवा प्रभावित न हो; personal information collect न करें; और technical protection measures मिलने पर उन्हें bypass करने की कोशिश करने के बजाय strategy बदलें या authorization लें। Technical stability, compliance judgment का विकल्प नहीं है।
यह सामग्री केवल तकनीकी शोध और development practice पर चर्चा के लिए है। Target site की शर्तों और आपके स्थान पर लागू कानूनों का पालन करें।


