
Der Agent entscheidet, Playwright bedient den Browser – doch die Umgebungsschicht wird oft übersehen. Bei langfristig laufenden Erfassungsaufgaben häufen sich Fehler genau dort.
Wenn ein Agent-Framework den Browser für die Datenerfassung steuert, besteht die Architektur meist aus drei Ebenen: Der Agent plant und entscheidet, Playwright übernimmt Klicks, Eingaben und das Auslesen von Daten, und am Ende interagiert der Ablauf mit der Zielwebsite. Kurze Aufgaben laufen oft problemlos und bestehen auch lokale Tests. Sobald die Laufzeit steigt und mehr Aufgaben parallel verteilt werden, konzentrieren sich die Fehler jedoch auf einen Bereich, der selten ernst genug genommen wird: die Browserumgebung.
Aus praktischen Erfahrungen lassen sich Probleme auf der Umgebungsebene grob in drei Formen einteilen.
Die Umgebung wird als auffällig eingestuft und die gesamte Pipeline stoppt
Eine Variante ist, dass die Plattform direkt auf die Umgebung reagiert. Das zeigt sich häufig nicht als vollständige Sperre, sondern als Herabstufung: vereinfachte Seiten, leere Ergebnisse oder zusätzliche Verifizierungen. Das Skript wirft keinen Fehler, aber die zurückgegebenen Daten sind nicht mehr brauchbar. Nachgelagerte Schritte laufen trotzdem weiter und tragen den Fehler bis in die letzte Tabelle.
Schwierig wird es, weil solche Umgebungen oft von mehreren Aufgaben gemeinsam genutzt werden. Sobald eine Umgebung Probleme macht, können alle daran gebundenen Aufgaben ausfallen. Wiederholungsversuche helfen dann nicht, denn die Ursache liegt nicht im Skript.
Mehrere Aufgaben teilen eine Umgebung und vermischen ihre Sitzungen
Laufen Aufgaben gleichzeitig in derselben Browserinstanz, können Cookie, localStorage und IndexedDB einander überschreiben und Anmeldestatus verdrängen. Kurzfristig fällt das kaum auf; nach einigen Tagen treten dann scheinbar unerklärliche erneute Anmeldungen auf.
Hinzu kommt eine subtilere Drift. In einem lange laufenden Browser verändern sich Cache, Speicher und sogar der WebGL-Renderingzustand nach und nach. Dieselbe Umgebung kann heute andere Merkmale haben als drei Tage später. Häufig wird dann ein abgelaufenes Cookie vermutet, obwohl sich die Umgebung selbst verändert hat. Deshalb lohnt es sich, Umgebungen als persistente, wiederverwendbare Objekte zu behandeln, statt jedes Mal einen neuen Browser zu starten.
Beim Fortsetzen kann die ursprüngliche Umgebung bereits unbrauchbar sein
Erfassungsaufgaben werden selten in einem einzigen Durchlauf abgeschlossen. Nach einer Unterbrechung an einem Prüfpunkt weiterzumachen ist üblich, führt aber leicht zu unnötiger Arbeit: Beim Neustart des Skripts wird nebenbei eine neue Browserinstanz erzeugt und der Anmeldestatus geht verloren; oder die alte Umgebung wird weiterverwendet, obwohl sie von der Plattform bereits markiert wurde, sodass jeder weitere Lauf nur Ressourcen verbraucht.
Entscheidend ist daher nicht die Zahl der Wiederholungsversuche, sondern die Granularität der Wiederherstellung. Wenn nicht außerhalb des Skripts festgehalten wird, bei welchem Schritt die Aufgabe steht, welche Daten bereits vorliegen und welche Umgebung verwendet wurde, bleibt nach einem Neustart nur der Anfang von vorn.
Was sich auf der Umgebungsebene tun lässt
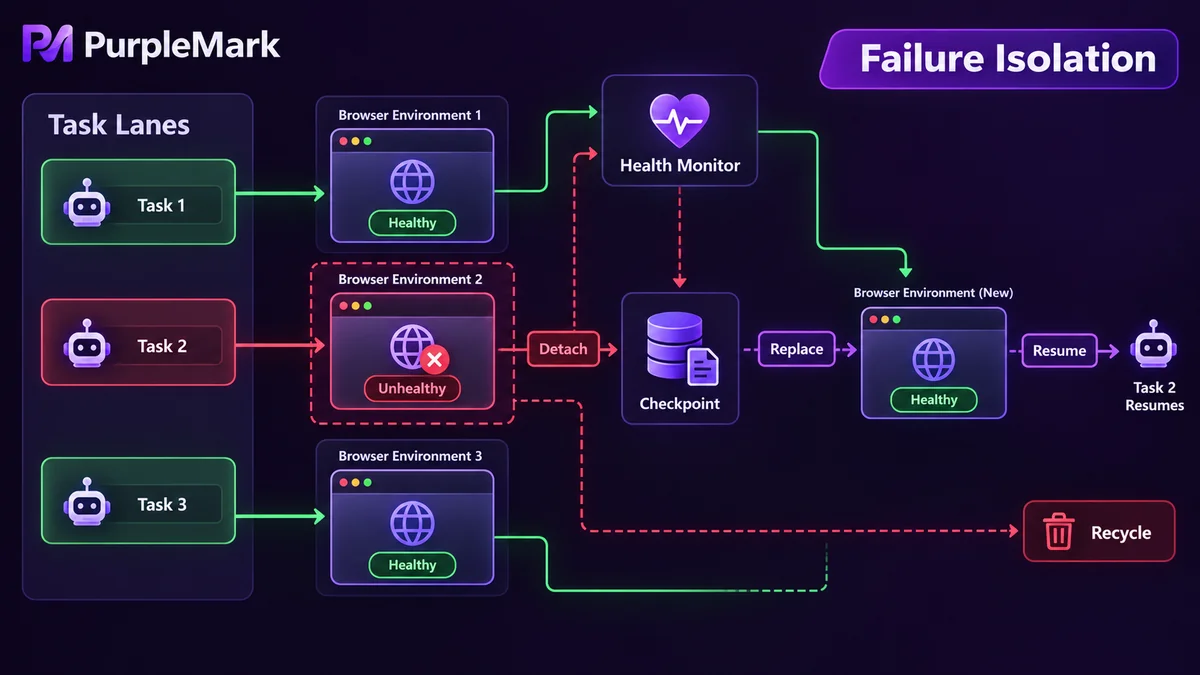
Zusammengenommen ergeben sich daraus drei Grundideen.
Umgebungen nach Aufgaben gruppieren. Eine Aufgabe sollte eine eigene Gruppe von Umgebungen erhalten, statt mehrere Aufgaben in eine Instanz zu zwängen. Danach lassen sich je Aufgabe eigener Netzwerkausgang, Zeitzone und Sprache konfigurieren. Als abgestimmtes Paket sind diese Parameter zuverlässiger als einzeln manuell gesetzte Werte. PurpleMark übernimmt in einer solchen Architektur die Umgebungsebene: Browserumgebungen werden stapelweise erstellt, jede Umgebung erhält einen eigenen Netzwerkausgang, und über eine API werden sie der Orchestrierungsschicht zur Planung bereitgestellt.
Fehler isolieren. Wird eine Umgebung als auffällig erkannt, sollten nur die daran hängenden Aufgaben betroffen sein. Üblich ist, für jede Umgebung einen Gesundheitsstatus zu führen, regelmäßig zu prüfen und eine auffällige Umgebung durch eine Reserve zu ersetzen, statt dass übergeordnete Skripte dieselbe defekte Umgebung immer wieder versuchen. Gleichzeitig wird die Ursache klarer: Liegt es an der Umgebung oder hat sich die Seitenstruktur geändert?
Zustand wiederherstellbar machen. Fortschritt, Deduplizierungs-Fingerprints und Umgebungskennungen werden dauerhaft außerhalb des Skripts gespeichert. Beim Neustart werden zuerst diese Daten gelesen; danach wird entschieden, wo fortgesetzt und welche Umgebung genutzt wird. Teilt man die Aufgabe in Phasen wie Erkennung, Laden und Extraktion, können Fehler pro Phase behandelt werden, ohne einen gesamten Durchlauf zu verlieren. Auch Ressourcen müssen überwacht werden: Lange laufende Instanzen können Speicherlecks, eingefrorene Seiten und Verbindungs-Timeouts entwickeln, daher sollten ungültige Sitzungen regelmäßig recycelt werden.
Grenzen, die klar bleiben sollten
Ob eine Umgebung stabil ist und ob Daten erhoben werden dürfen, sind zwei verschiedene Fragen. Zuerst sollten robots-Regeln und Nutzungsbedingungen der Zielwebsite geprüft werden, denn viele Seiten schränken automatisierten Zugriff ausdrücklich ein; die Anfragerate darf den fremden Dienst nicht beeinträchtigen; personenbezogene Daten sollten nicht erhoben werden; und bei technischen Schutzmaßnahmen ist die richtige Reaktion, die Strategie anzupassen oder eine Genehmigung einzuholen, statt die Schutzmaßnahmen zu umgehen. Technische Stabilität ersetzt keine Compliance-Prüfung.
Dieser Inhalt dient ausschließlich dem technischen Austausch zu Forschung und Entwicklungspraxis. Maßgeblich sind die Bedingungen der Zielwebsite und die an Ihrem Standort geltenden Gesetze.


