
O Agent toma decisões e o Playwright opera o navegador, mas a camada de ambiente costuma ser negligenciada. Em tarefas de coleta de longa duração, as falhas tendem a se concentrar justamente ali.
Quando um framework de agentes controla o navegador para coletar dados, a arquitetura normalmente tem três camadas: o Agent planeja e toma decisões, o Playwright cuida de cliques, entradas e extração de dados, e o fluxo termina interagindo com o site de destino. Tarefas curtas costumam rodar bem e passar nos testes locais. Porém, quando o tempo de execução aumenta e as tarefas se expandem, as falhas começam a se concentrar em um ponto que raramente recebe atenção suficiente: o ambiente do navegador.
Olhando para problemas encontrados na prática, as falhas da camada de ambiente geralmente assumem três formas.
O ambiente é considerado anormal e todo o pipeline para
Um caso ocorre quando a própria plataforma age sobre o ambiente. Muitas vezes isso não aparece como um bloqueio direto, mas como uma degradação: páginas simplificadas, resultados vazios ou exigência de verificação. O script não lança erro, mas os dados retornados deixam de ser úteis. As etapas seguintes continuam normalmente e carregam o problema até a tabela final.
A dificuldade é que esses ambientes costumam ser compartilhados por várias tarefas. Se um ambiente apresenta problema, todas as tarefas ligadas a ele podem parar. Tentar novamente não resolve, porque a causa não está no script.
Várias tarefas compartilham um ambiente e os estados de sessão se misturam
Quando tarefas são executadas em paralelo na mesma instância de navegador, Cookie, localStorage e IndexedDB podem sobrescrever uns aos outros e deslocar estados de login. Em pouco tempo isso pode passar despercebido, mas depois de alguns dias começam a surgir pedidos inesperados de novo login.
Também existe um tipo mais sutil de drift. Em um navegador que permanece ativo por muito tempo, cache, armazenamento e até o estado de renderização WebGL acumulam mudanças gradualmente. O mesmo ambiente pode apresentar características diferentes hoje e três dias depois. Muitas vezes se presume que a Cookie expirou, quando na verdade o próprio ambiente já mudou. Por isso, tratar ambientes como objetos persistentes e reutilizáveis tende a ser mais eficiente do que iniciar um navegador novo a cada execução.
Ao retomar de um checkpoint, o ambiente original pode não servir mais
Tarefas de coleta raramente terminam em uma única execução. Retomar a partir de um checkpoint depois de uma interrupção é comum, mas também é fácil desperdiçar trabalho: ao reiniciar o script, uma nova instância de navegador pode ser criada e o estado de login se perde; ou o ambiente antigo continua sendo usado mesmo depois de ter sido marcado pela plataforma, fazendo com que continuar apenas consuma recursos.
O ponto principal não é a quantidade de tentativas, mas a granularidade da recuperação. Se o estágio atual da tarefa, os dados já obtidos e o ambiente usado não forem registrados fora do script, um reinício obriga a começar tudo de novo.
O que pode ser feito na camada de ambiente
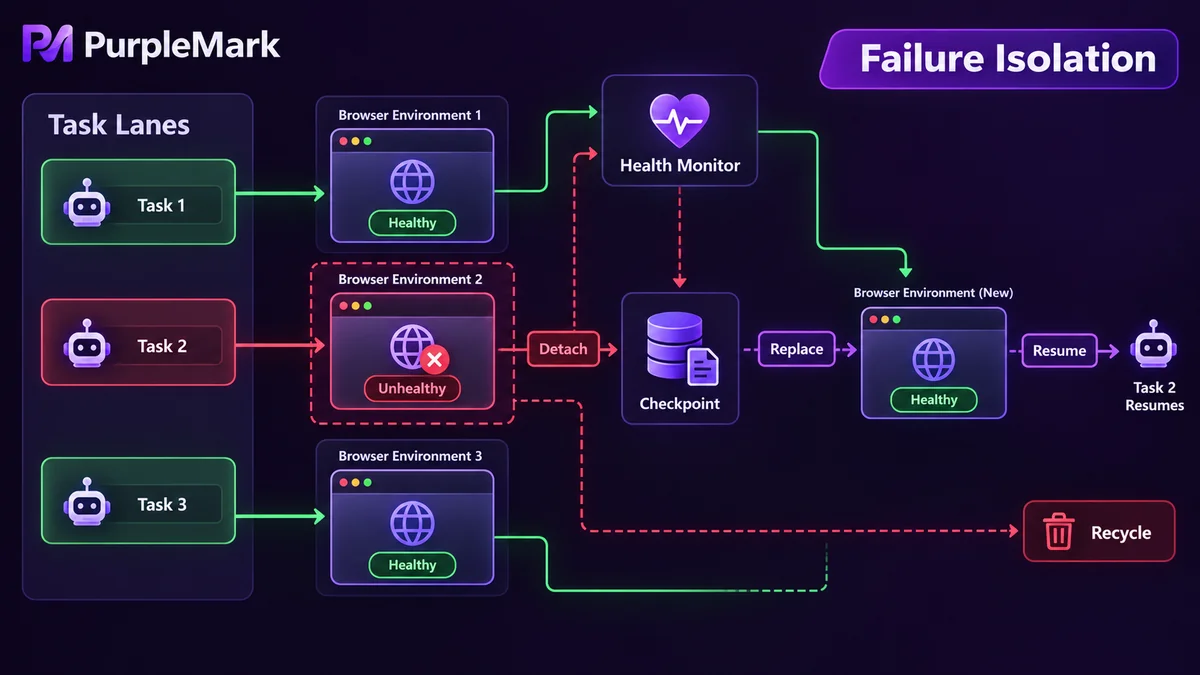
Juntando os três problemas, a abordagem se resume a três ideias.
Agrupe os ambientes por tarefa. Dê a cada tarefa um grupo próprio de ambientes, em vez de colocar várias tarefas na mesma instância. Depois do agrupamento, cada tarefa pode ter sua própria saída de rede, fuso horário e configuração de idioma. Manter esses parâmetros coerentes como um conjunto é mais confiável do que defini-los manualmente e de forma isolada. Nessa arquitetura, o PurpleMark ocupa a camada de ambiente: cria ambientes de navegador em lote, associa cada um a uma saída de rede independente e os entrega por API à camada de orquestração de tarefas para agendamento.
Isole as falhas. Se um ambiente for considerado anormal, apenas as tarefas associadas a ele devem ser afetadas. Em geral, mantém-se um estado de saúde para cada ambiente, com verificações periódicas. Quando surge um problema, o ambiente é retirado e substituído por um reserva, em vez de fazer os scripts de nível superior repetirem tentativas no mesmo ambiente defeituoso. Isso também facilita o diagnóstico: fica mais claro se o problema está no ambiente ou se a estrutura da página mudou.
Torne o estado recuperável. Progresso, fingerprints de deduplicação e identificadores de ambiente devem ser persistidos fora do script. Ao reiniciar, leia primeiro esses registros e depois decida de onde continuar e qual ambiente utilizar. Separar a tarefa em fases como descoberta, carregamento e extração permite tratar erros em cada etapa, evitando que uma falha pontual desperdice toda a execução. Os recursos também precisam de atenção: instâncias de longa duração podem apresentar vazamentos de memória, páginas travadas e timeouts de conexão, por isso sessões inválidas devem ser recicladas periodicamente.
Limites que precisam permanecer claros
A estabilidade do ambiente e a permissão para coletar dados são questões diferentes. Primeiro, verifique as regras de robots e os termos de serviço do site de destino, pois muitos sites limitam explicitamente o acesso automatizado; mantenha a frequência de solicitações em um nível que não afete o serviço alheio; não colete informações pessoais; e, diante de medidas técnicas de proteção, o correto é ajustar a estratégia ou obter autorização, não tentar contorná-las. Estabilidade técnica não substitui avaliação de conformidade.
Este conteúdo destina-se apenas à pesquisa técnica e ao intercâmbio de práticas de desenvolvimento. Respeite os termos do site de destino e as leis aplicáveis em sua localidade.


