
El agente decide y Playwright opera el navegador, pero la capa de entorno suele quedar desatendida. En tareas de extracción de larga duración, los fallos tienden a concentrarse allí.
Cuando un framework de agentes controla el navegador para recopilar datos, la arquitectura suele tener tres capas: el agente planifica y toma decisiones, Playwright se encarga de hacer clic, introducir datos y extraer información, y el flujo termina interactuando con el sitio de destino. Las tareas cortas suelen funcionar bien y pasar las pruebas locales. Sin embargo, cuando se alarga el tiempo de ejecución y se amplía el número de tareas, los fallos empiezan a concentrarse en un punto al que rara vez se presta suficiente atención: el entorno del navegador.
A partir de problemas encontrados en la práctica, los fallos de la capa de entorno suelen adoptar tres formas.
El entorno se considera anómalo y se detiene toda la canalización
Un caso es que la propia plataforma actúe sobre el entorno. A menudo no se manifiesta como un bloqueo directo, sino como una degradación: páginas simplificadas, resultados vacíos o solicitudes de verificación. El script no genera un error, pero los datos devueltos ya no sirven. Los pasos posteriores siguen ejecutándose y el problema llega hasta la tabla final.
La dificultad es que estos entornos suelen compartirse entre varias tareas. Si un entorno falla, todas las tareas asociadas pueden detenerse. Reintentar tampoco resuelve nada, porque el problema no está en el script.
Varias tareas comparten un entorno y las sesiones se contaminan
Cuando varias tareas se ejecutan al mismo tiempo en una sola instancia del navegador, Cookie, localStorage e IndexedDB pueden sobrescribirse entre sí y desplazar los estados de inicio de sesión. Al principio puede no notarse, pero después de varios días aparecen inicios de sesión inesperados.
También existe una deriva más difícil de detectar. En un navegador que funciona durante mucho tiempo, la caché, el almacenamiento e incluso el estado de renderizado de WebGL acumulan cambios. El mismo entorno puede mostrar características distintas hoy y tres días después. Muchas veces se atribuye a una Cookie caducada, cuando en realidad el entorno ya no es el mismo. Por eso suele resultar más rentable tratar los entornos como objetos persistentes y reutilizables que iniciar un navegador nuevo cada vez.
Al reanudar desde un punto de control, el entorno original puede haber dejado de servir
Las tareas de recopilación rara vez terminan en una sola ejecución. Reanudarlas desde un punto de control tras una interrupción es habitual, y también es fácil desperdiciar trabajo: al reiniciar el script se puede crear una nueva instancia del navegador y perder el estado de sesión; o puede mantenerse el entorno anterior aunque la plataforma ya lo haya marcado, de modo que continuar solo consume recursos.
La clave no es tanto el número de reintentos como la granularidad de la recuperación. Si no se guarda fuera del script en qué paso está la tarea, qué datos ya se obtuvieron y qué entorno se utilizaba, al reiniciar solo queda empezar desde cero.
Qué se puede hacer en la capa de entorno
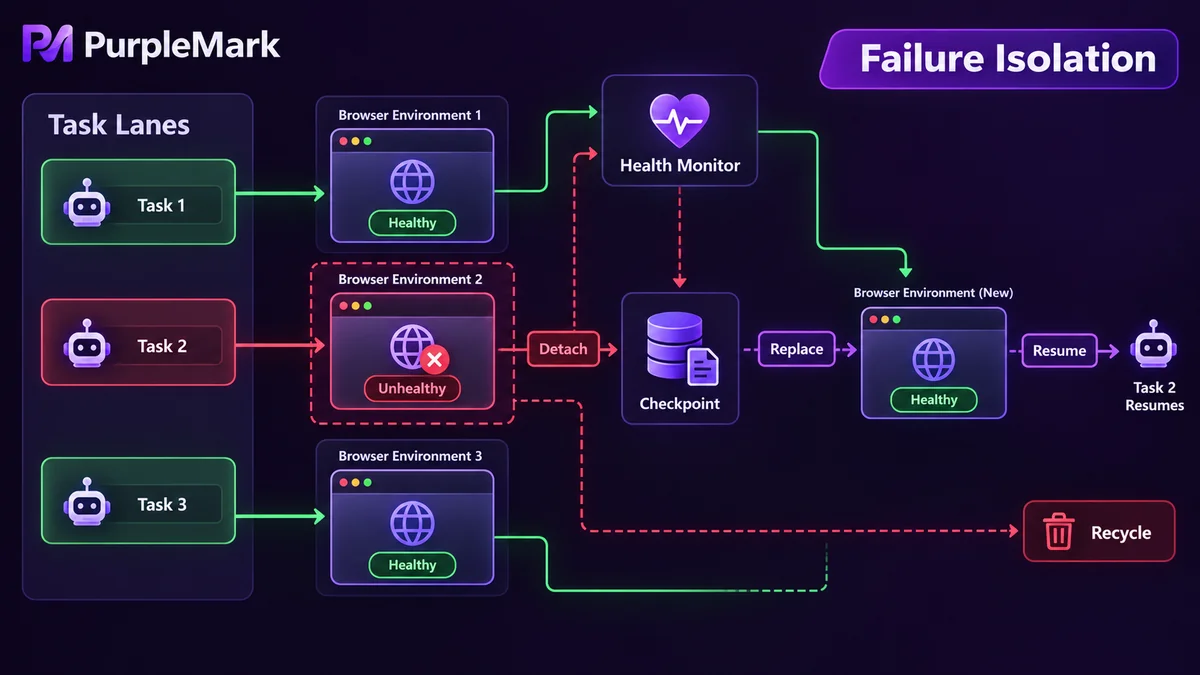
Si reunimos los tres problemas, la estrategia se resume en tres ideas.
Agrupar los entornos por tarea. Cada tarea debe disponer de un grupo de entornos y no compartir una sola instancia con varias tareas. Tras agruparlos, cada tarea puede configurar su propia salida de red, zona horaria e idioma. Mantener estos parámetros como un conjunto coherente es más fiable que ajustarlos manualmente por separado. En esta arquitectura, PurpleMark ocupa la capa de entorno: crea entornos de navegador por lotes, asigna a cada uno una salida de red independiente y los entrega mediante API a la capa de orquestación para su programación.
Aislar los fallos. Si un entorno se considera anómalo, solo deben verse afectadas las tareas asociadas a él. Lo habitual es mantener un estado de salud para cada entorno, revisarlo periódicamente y retirar los entornos problemáticos para sustituirlos por otros de reserva, en lugar de hacer que los scripts superiores reintenten una y otra vez el mismo entorno defectuoso. Además, así resulta más fácil distinguir si el problema está en el entorno o en un cambio de la estructura de la página.
Hacer recuperable el estado. El progreso, las huellas de deduplicación y los identificadores de entorno deben guardarse de forma persistente fuera del script. Al reiniciar, se leen primero esos registros y después se decide desde dónde continuar y qué entorno utilizar. Dividir la tarea en fases como descubrimiento, carga y extracción permite manejar errores por separado, de modo que un fallo puntual no invalide toda la ejecución. También hay que vigilar los recursos: las instancias de larga duración pueden sufrir fugas de memoria, páginas bloqueadas y tiempos de espera de conexión, por lo que conviene reciclar periódicamente las sesiones inválidas.
Límites que deben quedar claros
La estabilidad del entorno y la posibilidad de recopilar datos son cuestiones distintas. Primero hay que revisar las reglas de robots y las condiciones de servicio del sitio de destino, ya que muchos sitios limitan expresamente el acceso automatizado; la frecuencia de solicitudes debe mantenerse a un nivel que no afecte al servicio ajeno; no se deben recopilar datos personales; y, ante medidas técnicas de protección, lo correcto es ajustar la estrategia u obtener autorización, no intentar eludirlas. La estabilidad técnica no sustituye una evaluación de cumplimiento.
Este contenido se ofrece únicamente para investigación técnica e intercambio sobre prácticas de desarrollo. Deben respetarse las condiciones del sitio de destino y la normativa aplicable en su ubicación.


